语音交互
语音交互把麦克风输入接入当前设备会话。选中设备后,识别出的请求使用当前设备智能体的模型、工具和协作范围,回答通过语音播报。
使用前准备
启用语音前,需要先完成以下准备:
- 已创建设备智能体,并为目标设备定义好设备模型。语音请求最终会落到这些命令、属性字段和事件上。
- 目标设备已通过 IoT 平台、MQTT 或 SDK 接入,查询和控制已完成验证。
- 已准备可用的语音识别和语音合成服务商凭证。
- 控制台使用需要浏览器麦克风权限;SDK/设备端接入需要设备端能采集麦克风音频并播放合成音频。
配置语音服务
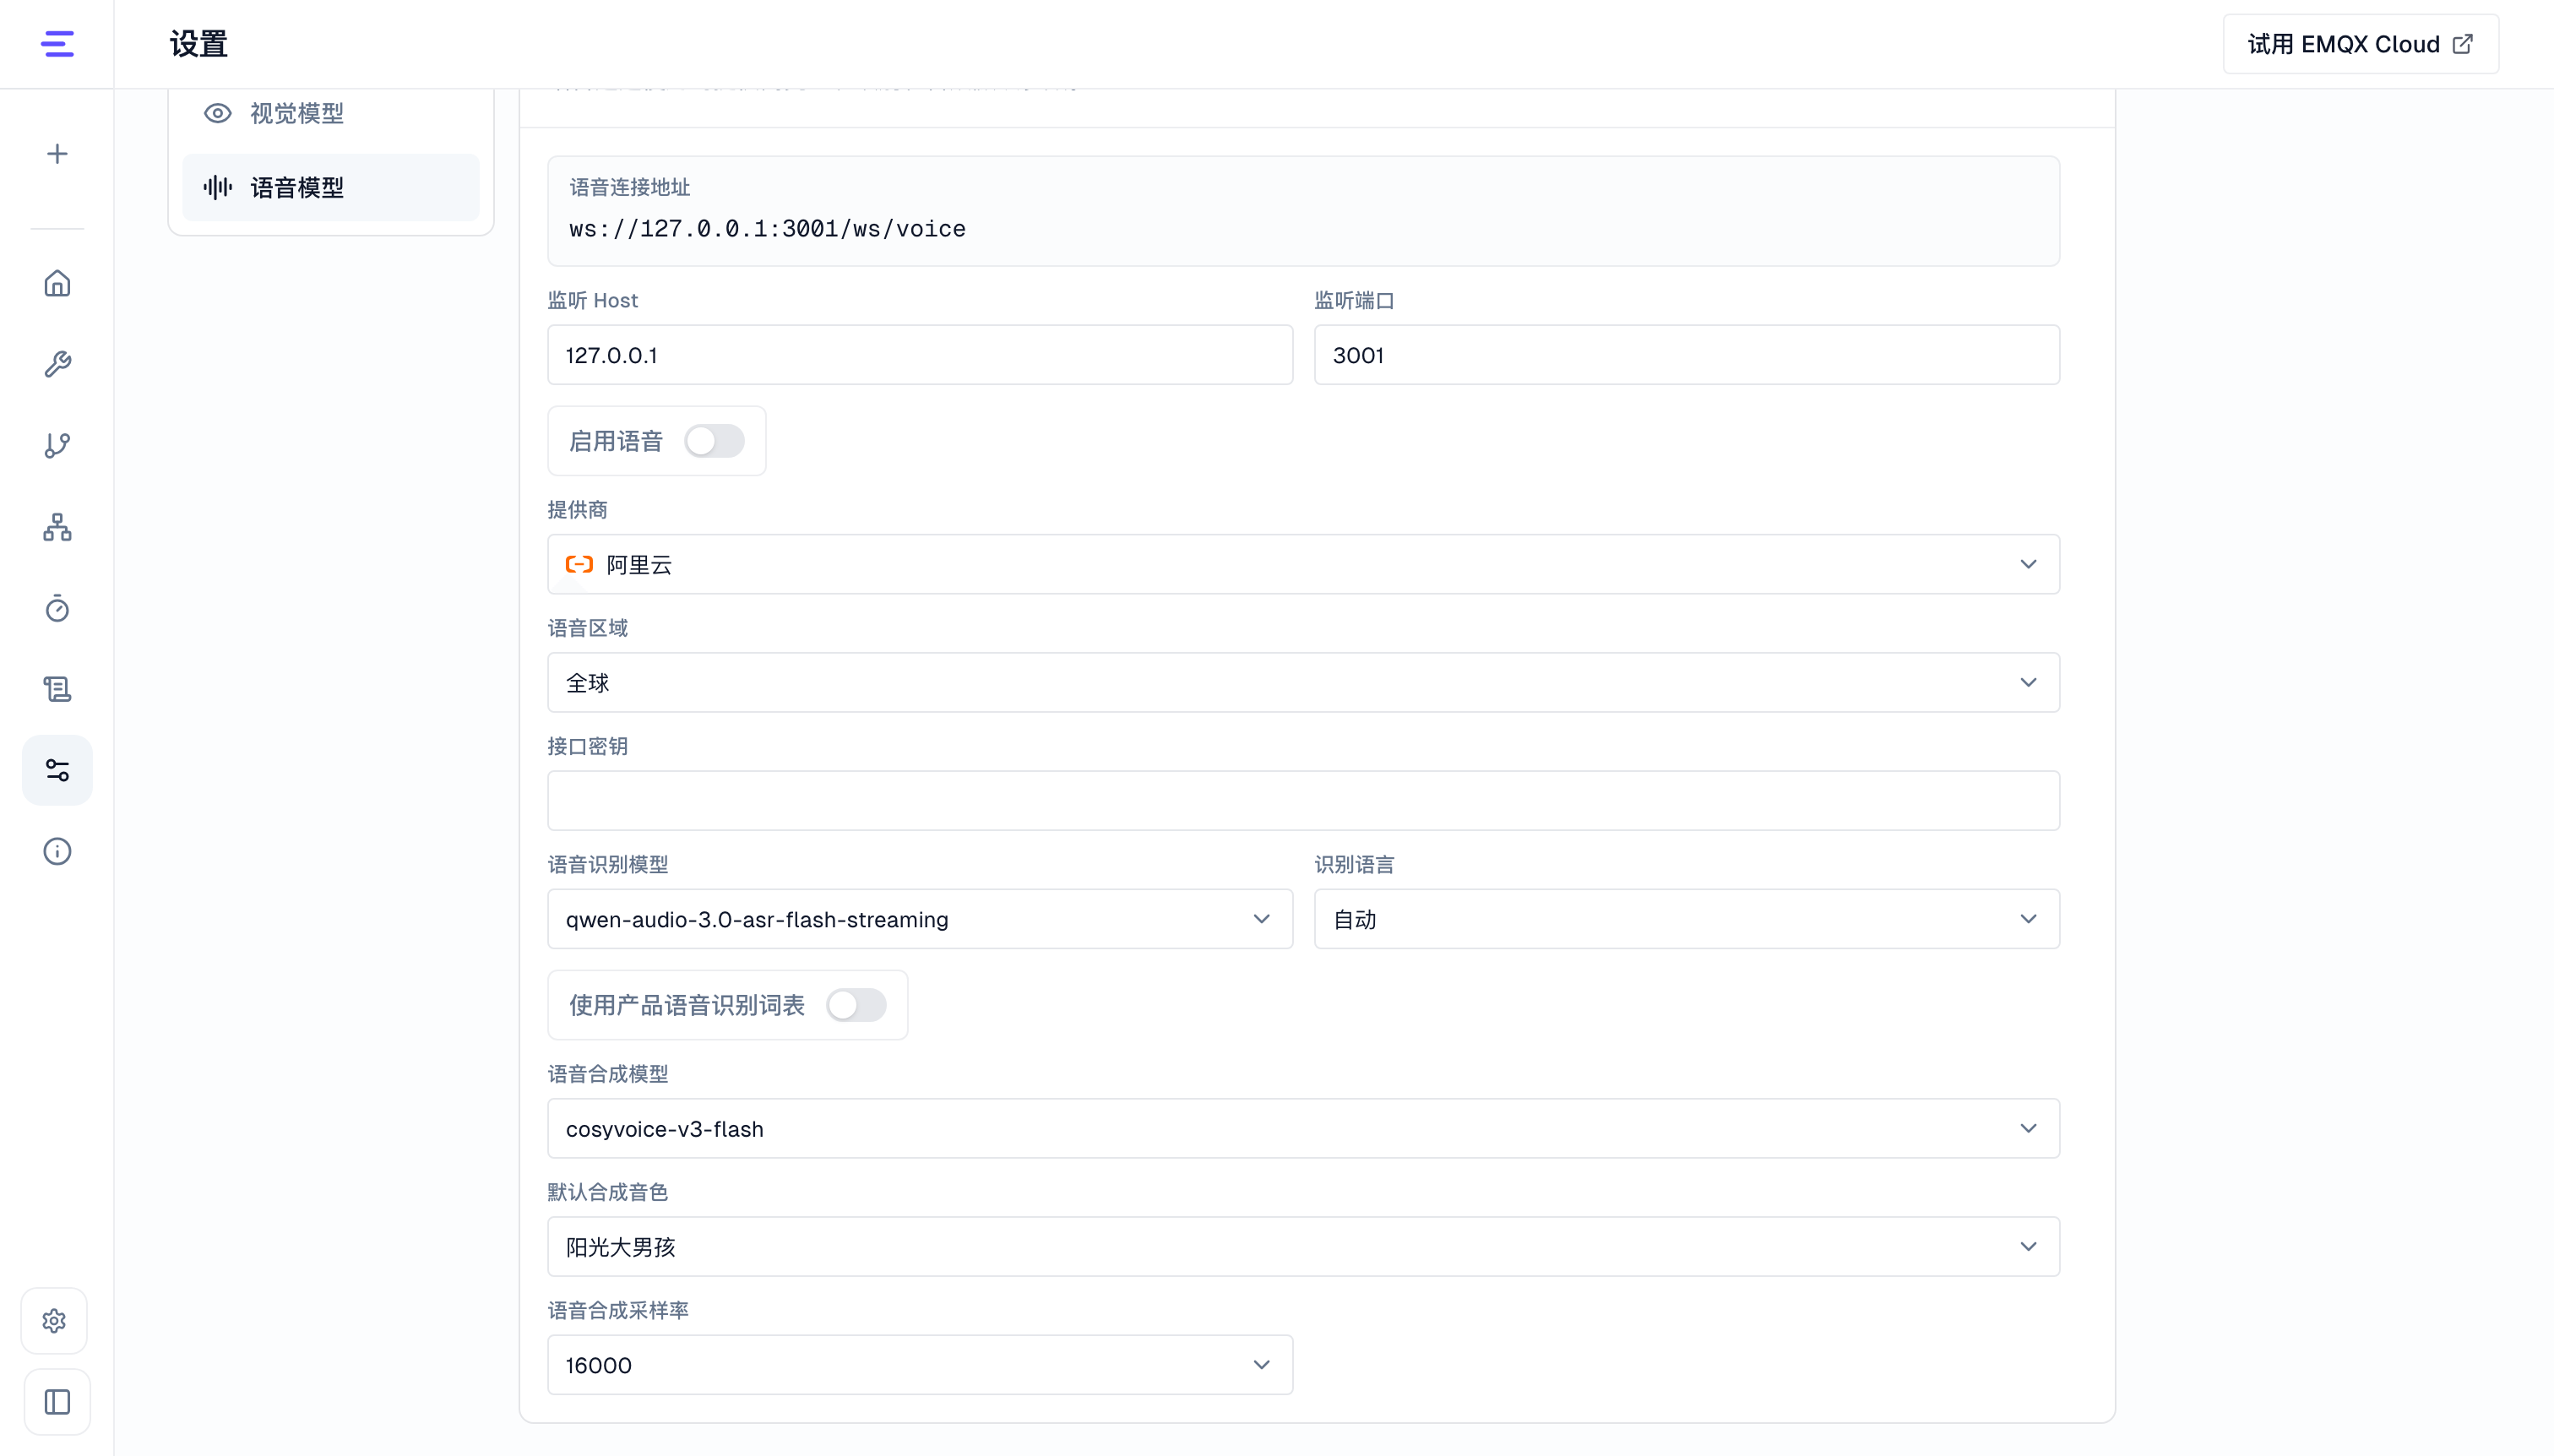
在 设置 → 模型 → 语音模型 中启用语音能力,并选择语音服务商。当前支持:
| 服务商 | 能力 | 获取凭证 | 识别模型 | 合成模型与音色 |
|---|---|---|---|---|
| 火山引擎 | 语音识别和语音合成 | APP ID 与 Access Token | 识别资源 ID | 合成资源 ID、音色列表 |
| 阿里云 | 语音识别和语音合成 | API Key | 实时语音识别 | 实时语音合成、CosyVoice 音色、Qwen-Audio-TTS 音色 |
| AWS | Transcribe 语音识别和 Polly 语音合成 | 访问密钥 | Transcribe 支持的语言 | Polly 音色 |
| ElevenLabs | 语音识别和语音合成 | API Key | 模型列表 | 模型列表、音色库 |
音色需要与合成模型匹配:火山引擎的合成资源 ID 决定可用的音色版本,阿里云 CosyVoice 与 Qwen-Audio-TTS 使用各自的音色列表。可用的模型和音色以服务商账号为准。
常用配置包括:
- 是否启用语音。
- 语音监听地址和端口。
- 语音区域、服务商凭证、识别模型、合成模型和音色。
识别采样率和语音 TLS 通过环境变量配置;配置及远程接入方式见语音配置。
控制台使用和 SDK 接入
语音交互有两条使用路径。通常先用控制台验证识别质量和控制链路,再接入 SDK 到真实设备。
| 路径 | 适用场景 | 需要完成 |
|---|---|---|
| 控制台使用 | 开发调试、演示、验证设备模型是否适合语音控制 | 启用语音配置,选中设备后用浏览器麦克风发起请求 |
| SDK/设备端接入 | 设备本身带麦克风、扬声器或系统音频接口 | 设备端连接 /ws/voice,发送音频帧,播放返回的 TTS 音频 |
两种方式都会进入同一个设备智能体会话,并使用同一份设备模型。
控制台使用
进入设备智能体工作区并选中设备,打开语音入口。后续语音请求都会绑定到这台设备。
控制台使用时可以:
- 发起一条和设备模型相关的语音指令,例如查询状态、调整参数或触发某个动作。
- 查看识别文本是否准确,并确认设备智能体是否调用了预期命令或读取了预期状态。
- 听取语音回复,必要时中断当前朗读。
- 将识别出的文本转回输入框继续编辑,用于排查识别错误或提示词问题。
如果同时开启摄像头,语音请求结束时可以携带当前画面。设备智能体会在用户询问可见内容时使用视觉能力,例如识别状态灯、读取屏幕文字或判断画面中的物体。
SDK/设备端接入
生成包提供语音能力时,可使用包内连接信息与示例;没有预置示例时,按 WebSocket 协议自行接入。设备端接入步骤如下:
- 先启动设备端 MQTT 或 SDK 连接,确认设备在控制台在线。
- 从部署获取语音连接地址、认证方式和音频参数;生成包已提供配置时使用包内信息,再连接语音服务的
/ws/voice。 - 建立连接后发送
hello,带上设备 ID、会话 ID、服务商和音频参数。 - 用户开始说话时发送
listen,随后持续发送 16 kHz、单声道、Int16LE PCM 音频帧。 - 用户结束说话时发送
stop。如需结合摄像头画面,可在结束时带上视觉帧引用。 - 监听识别文本、设备智能体回复和 TTS 音频帧,把音频帧接到设备扬声器或系统音频播放。
当前接入方式支持设备凭证认证时,设备端也可以使用平台提供的设备身份连接语音服务;具体认证方式以部署为准。协议消息、连接参数和 hello 示例见 API 参考。
语音请求触发设备控制时,真实设备仍然通过 MQTT 或 SDK 收到命令并返回响应。设备端不需要维护额外的“语音命令”分支,以免和设备模型中的命令定义不一致。
如需生成带麦克风、扬声器或系统音频接口适配逻辑的设备端代码,可以在 SDK 接入 中使用智能体适配和增强 SDK。
调整语音体验
在配置总览中维护识别热词、语音工具范围和回复与反馈。语音工具范围决定可以调用哪些工具;A2A 设备绑定仍用于检查协作目标。
查询设备状态时,在回复与反馈中设置正在查询当前数据等等待话术。提示用于说明处理进度;设备动作是否完成仍需检查最终结果与最新状态。
平台部署还可以使用监控查看响应时延和语音用量,单次问题结合日志检查。
验证结果
完成控制台配置或 SDK/设备端接入后,至少验证这些结果:
- 语音 WebSocket 可以连接,
hello能返回会话信息。 - 麦克风音频能被识别成文本,且识别文本进入当前设备的对话上下文。
- 查询类问题能读到真实设备状态,控制类指令能触发设备模型中定义的命令。
- 设备端能收到命令、返回执行结果,并在控制台或日志中看到对应记录。
- TTS 音频能在浏览器或真实设备上播放,
abort可以中断当前朗读。 - 远程访问或生产部署时,客户端使用部署管理员发布的公网语音 WebSocket 地址,包含正确的对外主机地址和端口;HTTPS 控制台使用
wss://。
注意事项
麦克风、服务商和连接要求见使用前准备和配置语音服务。语音功能更适合手动发起的短语音交互;长报告、复杂表格、代码、唤醒词和持续后台监听场景更适合放在语音流程之外处理。