语音配置
Device Agent 的语音通道负责语音识别(ASR)和语音合成(TTS)。语音请求会进入当前设备会话;真实设备上线、命令执行和状态上报仍通过所选 IoT 提供商、MQTT 或设备 SDK 完成。
控制台配置
打开 设置 → 模型 → 语音模型。本地控制台默认地址为 http://127.0.0.1:3000;平台使用部署提供的控制台地址。
| 字段 | 用途 |
|---|---|
| 启用语音 | 控制 /ws/voice 语音通道是否可用。 |
| 语音连接地址 | 用于本地直连的监听地址,默认为 ws://127.0.0.1:3001/ws/voice;平台客户端使用部署管理员发布的公网语音 WebSocket 地址 |
| 语音服务商 | 选择 volcengine、aliyun、aws 或 elevenlabs。 |
| 区域 | 支持 cn、us、eu、global,会影响可用服务商。 |
| 语音识别 | ASR 模型、语言或资源 ID,字段随服务商不同而变化。 |
| 使用产品语音识别词表 | 让支持的阿里云识别模型使用当前智能体的识别热词 |
| 语音合成 | TTS 模型、音色和采样率,字段随服务商不同而变化。 |
| 服务商密钥 | 填写所选服务的凭证;平台中显示配置状态,需要变更时联系部署管理员 |
先选择区域与服务商,再设置识别和合成参数,最后保存。本地的服务商、模型、音色和密钥保存后生效;启用状态、监听地址、端口或 TLS 修改需要重启。平台按页面提示完成保存和服务重启,并向部署管理员获取公网语音 WebSocket 地址;页面显示的监听地址可能与发布入口不同。
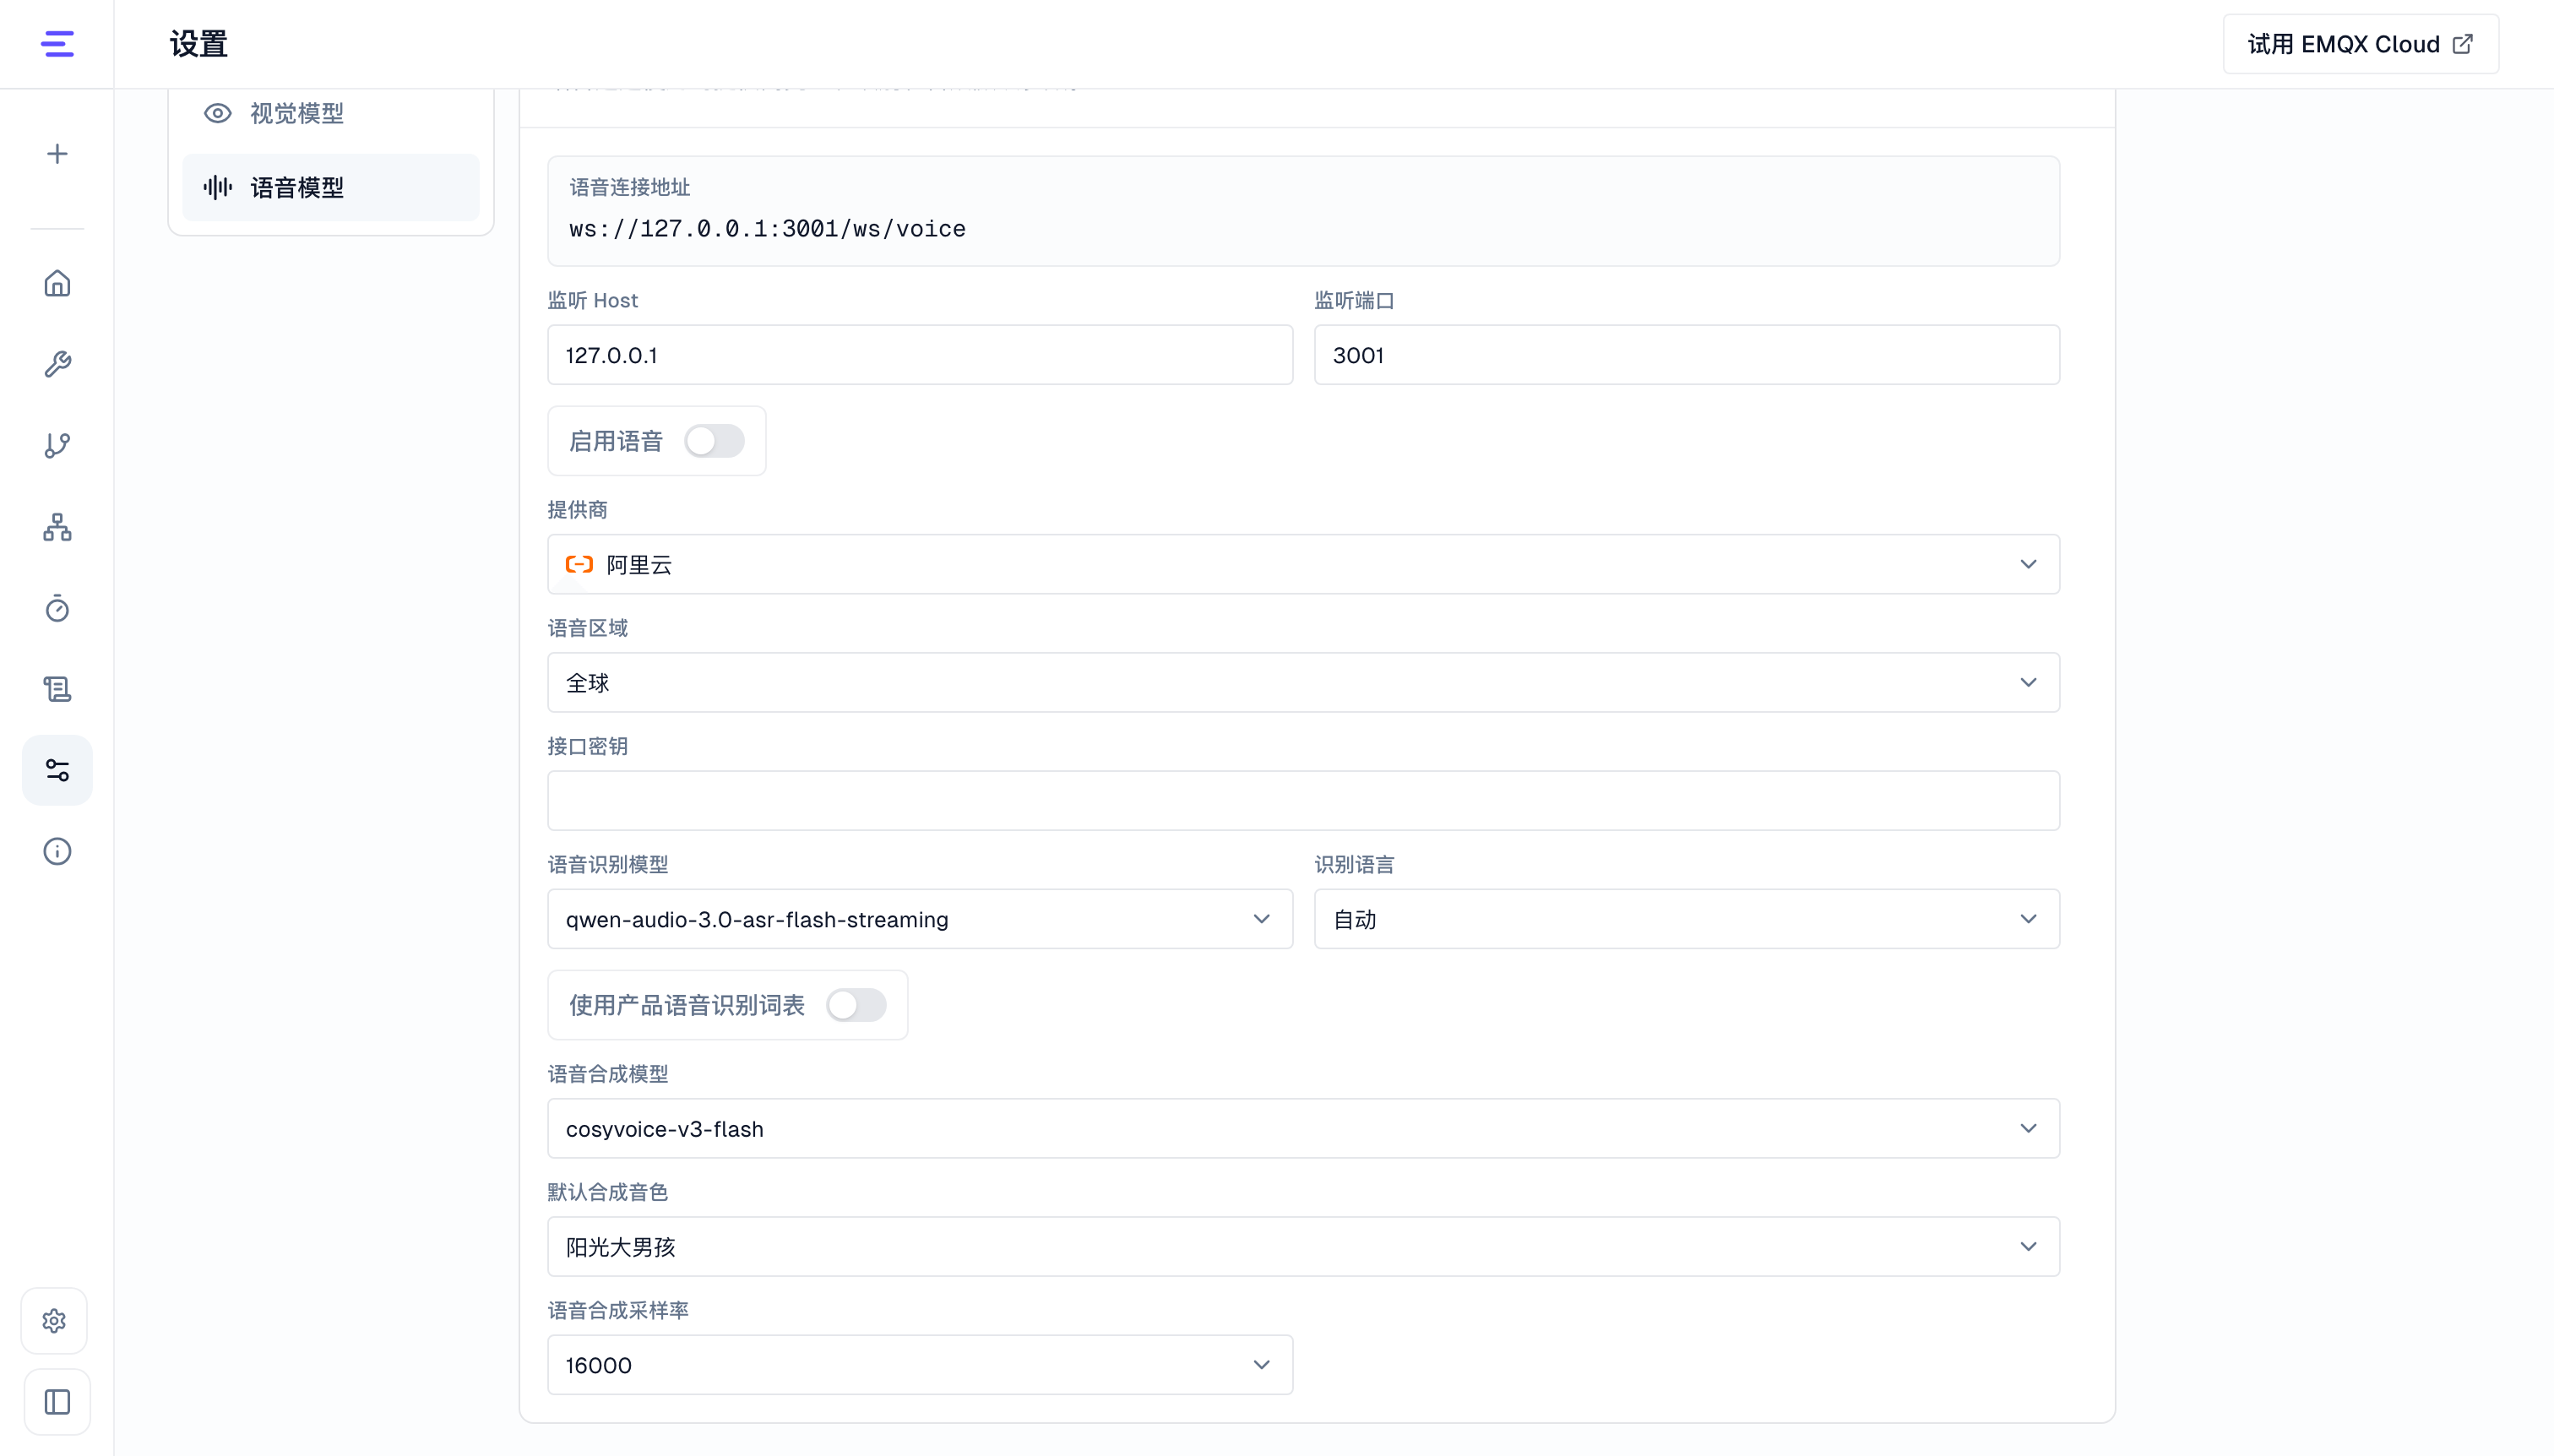
阿里云语音识别
选择阿里云后,可以在 ASR 模型 中选择以下模型:
| 模型 | 智能体热词支持 |
|---|---|
qwen-audio-3.0-asr-flash-streaming | 支持;当前默认模型 |
fun-asr-realtime | 支持 |
fun-asr-realtime-2026-02-28 | 支持 |
fun-asr-realtime-2025-11-07 | 支持 |
fun-asr-realtime-2025-09-15 | 支持 |
paraformer-realtime-v2 | 不支持当前词表功能 |
paraformer-realtime-v1 | 不支持当前词表功能;识别采样率使用 16 kHz |
使用支持自动识别的模型时,识别语言留空可以自动识别其支持的语言和中文方言。模型可用性以服务商账号和控制台选项为准。
使用智能体热词
设备名称或业务术语经常被听错时:
- 在目标智能体卡片的 更多 → 配置总览 → 语音识别 → 编辑配置 中添加热词与权重。
- 回到全局语音模型设置,选择支持词表的阿里云 ASR 模型。
- 开启 使用产品语音识别词表,保存配置。
- 建立新的语音连接,使用包含热词的句子检查识别文本。
词表来自当前设备智能体,同一全局语音服务可以使用各智能体自己的热词。切换到不支持词表的模型时,该开关不可开启。权重和热词维护见设备智能体配置。
阿里云语音合成与音色
当前 TTS 模型 提供以下选择:
| 系列 | 可选模型 |
|---|---|
| CosyVoice | cosyvoice-v3-flash、cosyvoice-v3-plus、cosyvoice-v2 |
| Qwen Audio | qwen-audio-3.0-tts-flash、qwen-audio-3.0-tts-plus |
先选择模型,再从对应音色中选择需要的声音。不同模型的系统音色不完全相同,切换模型后检查音色是否符合预期;已有音色不兼容时,界面会选择可用音色。
保存后发起一条短语音请求,确认实际播报的声音与播放速度。自定义音色还需要服务商账号具备相应使用权限。
设备智能体的语音体验
全局设置负责识别、合成和连接服务。单个智能体的热词、语音工具范围、身份回复、等待话术、问题匹配、音频复用和超时回复,在设备智能体配置中维护。
例如,需要等待查询结果时,可以先给出简短反馈;查询重复出现时,可以按配置匹配合适的话术。语音工具范围决定可调用的工具,A2A 设备绑定决定允许协作的目标。设置等待提示不会增加工具权限或设备能力。
使用与验证见语音交互。平台部署可以通过监控查看语音结果、时延和使用量。
语音服务商
| 服务商 | 适用区域 | 主要配置 |
|---|---|---|
火山引擎(volcengine) | cn、global | VOLCENGINE_SPEECH_APP_ID、VOLCENGINE_SPEECH_ACCESS_KEY,以及 ASR/TTS 资源 ID、语言、音色和采样率。 |
阿里云 DashScope(aliyun) | cn、global | ALIYUN_DASHSCOPE_API_KEY 或 QWEN_API_KEY,以及 ASR 模型、TTS 模型、音色和采样率。 |
AWS(aws) | us、eu、global | AWS_ACCESS_KEY_ID、AWS_SECRET_ACCESS_KEY、AWS_REGION,以及 Transcribe 语言和 Polly 音色。 |
ElevenLabs(elevenlabs) | us、eu、global | ELEVENLABS_API_KEY、API Endpoint、ASR 模型、TTS 模型、音色和采样率。 |
VOICE_REGION=cn 使用火山引擎或阿里云;us 使用 AWS 或 ElevenLabs;eu 要求 AWS eu-* 区域或 ElevenLabs EU residency endpoint;global 不限制服务商。
平台中的可选服务以部署已配置的凭据为准。
.env 配置
首次启动、容器部署或无 UI 环境可用 .env 配置语音服务。本地同名变量会在每次启动覆盖控制台保存值;平台凭据由部署管理员维护。详见配置生效规则。
阿里云 DashScope:
VOICE_ENABLED=true
VOICE_REGION=cn
ALIYUN_DASHSCOPE_API_KEY=sk-...
ALIYUN_ASR_MODEL=qwen-audio-3.0-asr-flash-streaming
ALIYUN_ASR_VOCABULARY_ENABLED=false
ALIYUN_TTS_MODEL=cosyvoice-v3-flash
ALIYUN_TTS_VOICE=longanyang
需要使用智能体热词时,确认模型支持后设置 ALIYUN_ASR_VOCABULARY_ENABLED=true。
火山引擎:
VOICE_ENABLED=true
VOICE_REGION=cn
VOLCENGINE_SPEECH_APP_ID=...
VOLCENGINE_SPEECH_ACCESS_KEY=...
VOLCENGINE_TTS_VOICE=zh_female_shuangkuaisisi_moon_bigtts
AWS:
VOICE_ENABLED=true
VOICE_REGION=us
AWS_ACCESS_KEY_ID=...
AWS_SECRET_ACCESS_KEY=...
AWS_REGION=us-east-1
AWS_TRANSCRIBE_LANGUAGE_CODE=en-US
AWS_POLLY_VOICE=Joanna
ElevenLabs:
VOICE_ENABLED=true
VOICE_REGION=us
ELEVENLABS_API_KEY=...
ELEVENLABS_TTS_MODEL_ID=eleven_multilingual_v2
ELEVENLABS_TTS_VOICE=UgBBYS2sOqTuMpoF3BR0完整变量见环境变量。
监听地址和 TLS
本地语音服务默认监听 127.0.0.1:3001。局域网或服务器客户端需要连接时,设置可访问的监听地址并重启:
VOICE_HOST=0.0.0.0
VOICE_PORT=3001
本地直连时,确认网络允许访问该端口,再从 设置 → 模型 → 语音模型 复制连接地址,并确认其中的主机地址和端口可从客户端访问。
HTTPS 控制台需要使用 wss:// 语音连接。本地语音监听服务可通过以下配置启用 TLS:
VOICE_TLS_ENABLED=true
VOICE_TLS_CERT_FILE=/path/to/cert.pem
VOICE_TLS_KEY_FILE=/path/to/key.pem
平台或反向代理接入时,使用部署管理员发布的语音 WebSocket 地址,并核对实际对外主机地址、端口和 /ws/voice 路径。发布的语音地址可能与控制台地址不同。HTTPS 控制台使用 wss://;TLS 可以在代理上终止,代理对外端口也可能与语音监听端口不同。