ConfluentへのMQTTデータストリーミング
Confluent CloudはApache Kafkaをベースにした、レジリエントでスケーラブル、かつフルマネージドのストリーミングデータサービスです。EMQXはルールエンジンとSinkを通じてConfluentとのデータ統合をサポートし、MQTTデータをConfluentに簡単にストリーミングしてリアルタイム処理、保存、分析を可能にします。
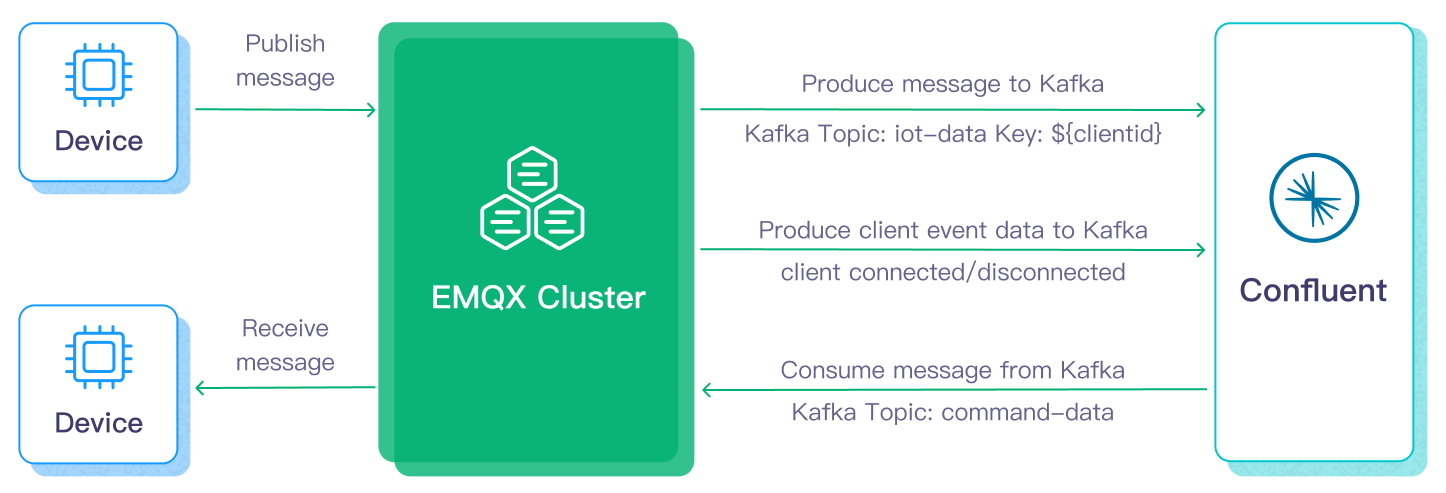
本ページでは主にConfluent統合の機能と利点を紹介し、Confluent Cloudの設定方法およびEMQXでのConfluent Producer Sinkの作成方法を案内します。
動作概要
Confluentデータ統合はEMQXの即利用可能な機能であり、MQTTベースのIoTデータとConfluentの強力なデータ処理機能を橋渡しします。組み込みのルールエンジンコンポーネントを利用することで、両プラットフォーム間のデータフローと処理を簡素化し、複雑なコーディングを不要にします。
以下の図は、自動車IoTにおけるEMQXとConfluentのデータ統合の典型的なアーキテクチャを示しています。
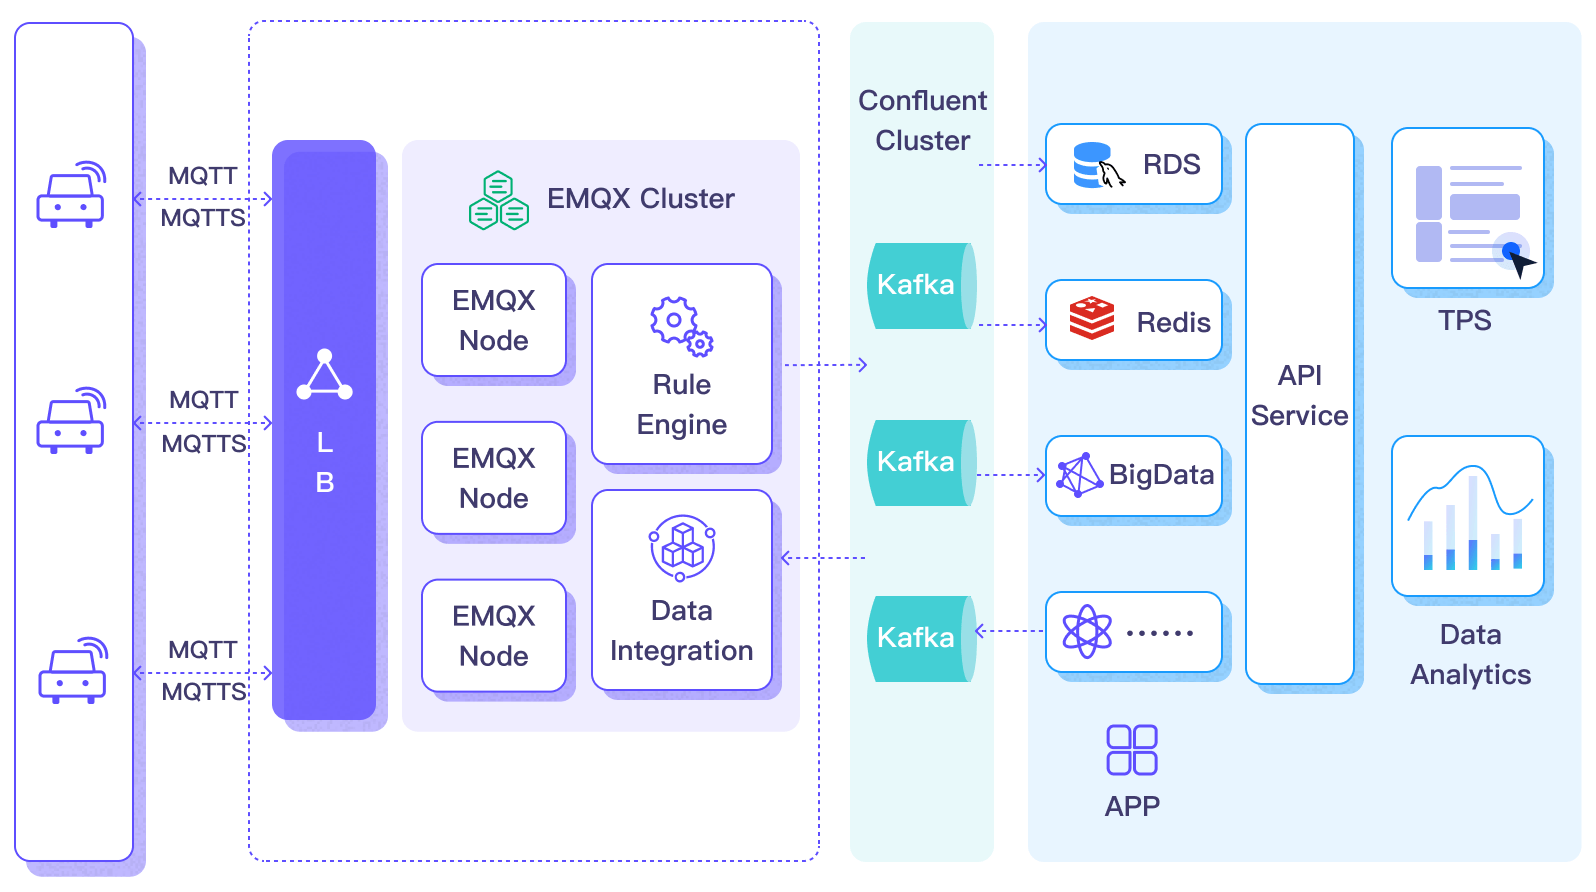
Confluentへのデータの入出力は、Confluent Sink(Confluentへメッセージを送信)とConfluent Source(Confluentからメッセージを受信)を介して行われます。Confluent Sinkを作成した場合、そのワークフローは以下の通りです。
- メッセージのパブリッシュと受信:車両に接続されたIoTデバイスはMQTTプロトコルでEMQXに正常に接続し、定期的に状態データを含むメッセージをパブリッシュします。EMQXがこれらのメッセージを受信すると、ルールエンジン内でマッチング処理を開始します。
- メッセージデータの処理:これらのMQTTメッセージは、組み込みのルールエンジンとメッセージサーバーの連携により、トピックマッチングルールに基づいて処理されます。メッセージが到着しルールエンジンを通過すると、事前定義された処理ルールが評価されます。ペイロード変換を指定するルールがあれば、データ形式変換、特定情報のフィルタリング、追加コンテキストによるペイロードの拡充などの変換が適用されます。
- Confluentへのブリッジング:ルールエンジンで定義されたルールがトリガーとなり、メッセージをConfluentに転送するアクションが実行されます。Confluent Sink機能を使い、MQTTトピックはConfluentの事前定義されたKafkaトピックにマッピングされ、処理済みのメッセージとデータがこれらのトピックに書き込まれます。
車両データがConfluentに入力されると、以下のように柔軟にデータを活用できます。
- サービスはConfluentと直接統合し、特定トピックからリアルタイムデータストリームを消費してカスタマイズされたビジネス処理を行えます。
- Kafka Streamsを利用したストリーム処理や、車両状態のメモリ内集約・相関によるリアルタイム監視が可能です。
- ConfluentのStream Designerコンポーネントを使い、MySQLやElasticSearchなど外部システムへのデータ出力を行う各種コネクターを選択できます。
機能と利点
Confluentとのデータ統合は以下の機能と利点をビジネスにもたらします。
- 大規模メッセージ伝送の信頼性:EMQXとConfluent Cloudは共に高信頼なクラスター機構を採用し、安定かつ信頼性の高いメッセージ伝送チャネルを構築します。大規模IoTデバイスからのメッセージのロスをゼロにし、ノード追加による水平スケールや動的リソース調整で急増する大量メッセージにも対応し、メッセージ伝送の可用性を確保します。
- 強力なデータ処理能力:EMQXのローカルルールエンジンとConfluent Cloudは、それぞれデバイスからアプリケーションまでの異なる段階で信頼性の高いストリーミングデータ処理機能を提供します。リアルタイムのデータフィルタリング、形式変換、集約分析などシナリオに応じた処理が可能で、より複雑なIoTメッセージ処理ワークフローを実現し、データ分析アプリケーションのニーズに応えます。
- 強力な統合機能:Confluent Cloudが提供する多様なコネクターを通じて、EMQXは他のデータベース、データウェアハウス、データストリーム処理システムなどと容易に統合でき、柔軟なデータ分析アプリケーションのための完全なIoTデータワークフローを構築します。
- 高スループット処理能力:同期・非同期の両書き込みモードをサポートし、リアルタイム優先と性能優先のデータ書き込み戦略を区別可能で、シナリオに応じてレイテンシとスループットを柔軟にバランスさせます。
- 効果的なトピックマッピング:ブリッジ設定を通じて多数のIoTビジネストピックをKafkaトピックにマッピング可能です。EMQXはMQTTユーザープロパティをKafkaヘッダーにマッピングでき、1対1、1対多、多対多の柔軟なトピックマッピング方式を採用し、MQTTトピックフィルター(ワイルドカード)にも対応します。
これらの機能は統合能力と柔軟性を高め、効果的かつ堅牢なIoTプラットフォームアーキテクチャの構築を支援します。増大するIoTデータは安定したネットワーク接続で伝送され、さらに効果的に保存・管理されます。
はじめる前に
このセクションでは、EMQXダッシュボードでConfluentデータ統合を設定するための準備作業について説明します。
前提条件
Confluent Cloudの設定
Confluentデータ統合を作成する前に、Confluent CloudコンソールでConfluentクラスターを作成し、Confluent Cloud CLIを使ってトピックとAPIキーを作成する必要があります。
クラスターの作成
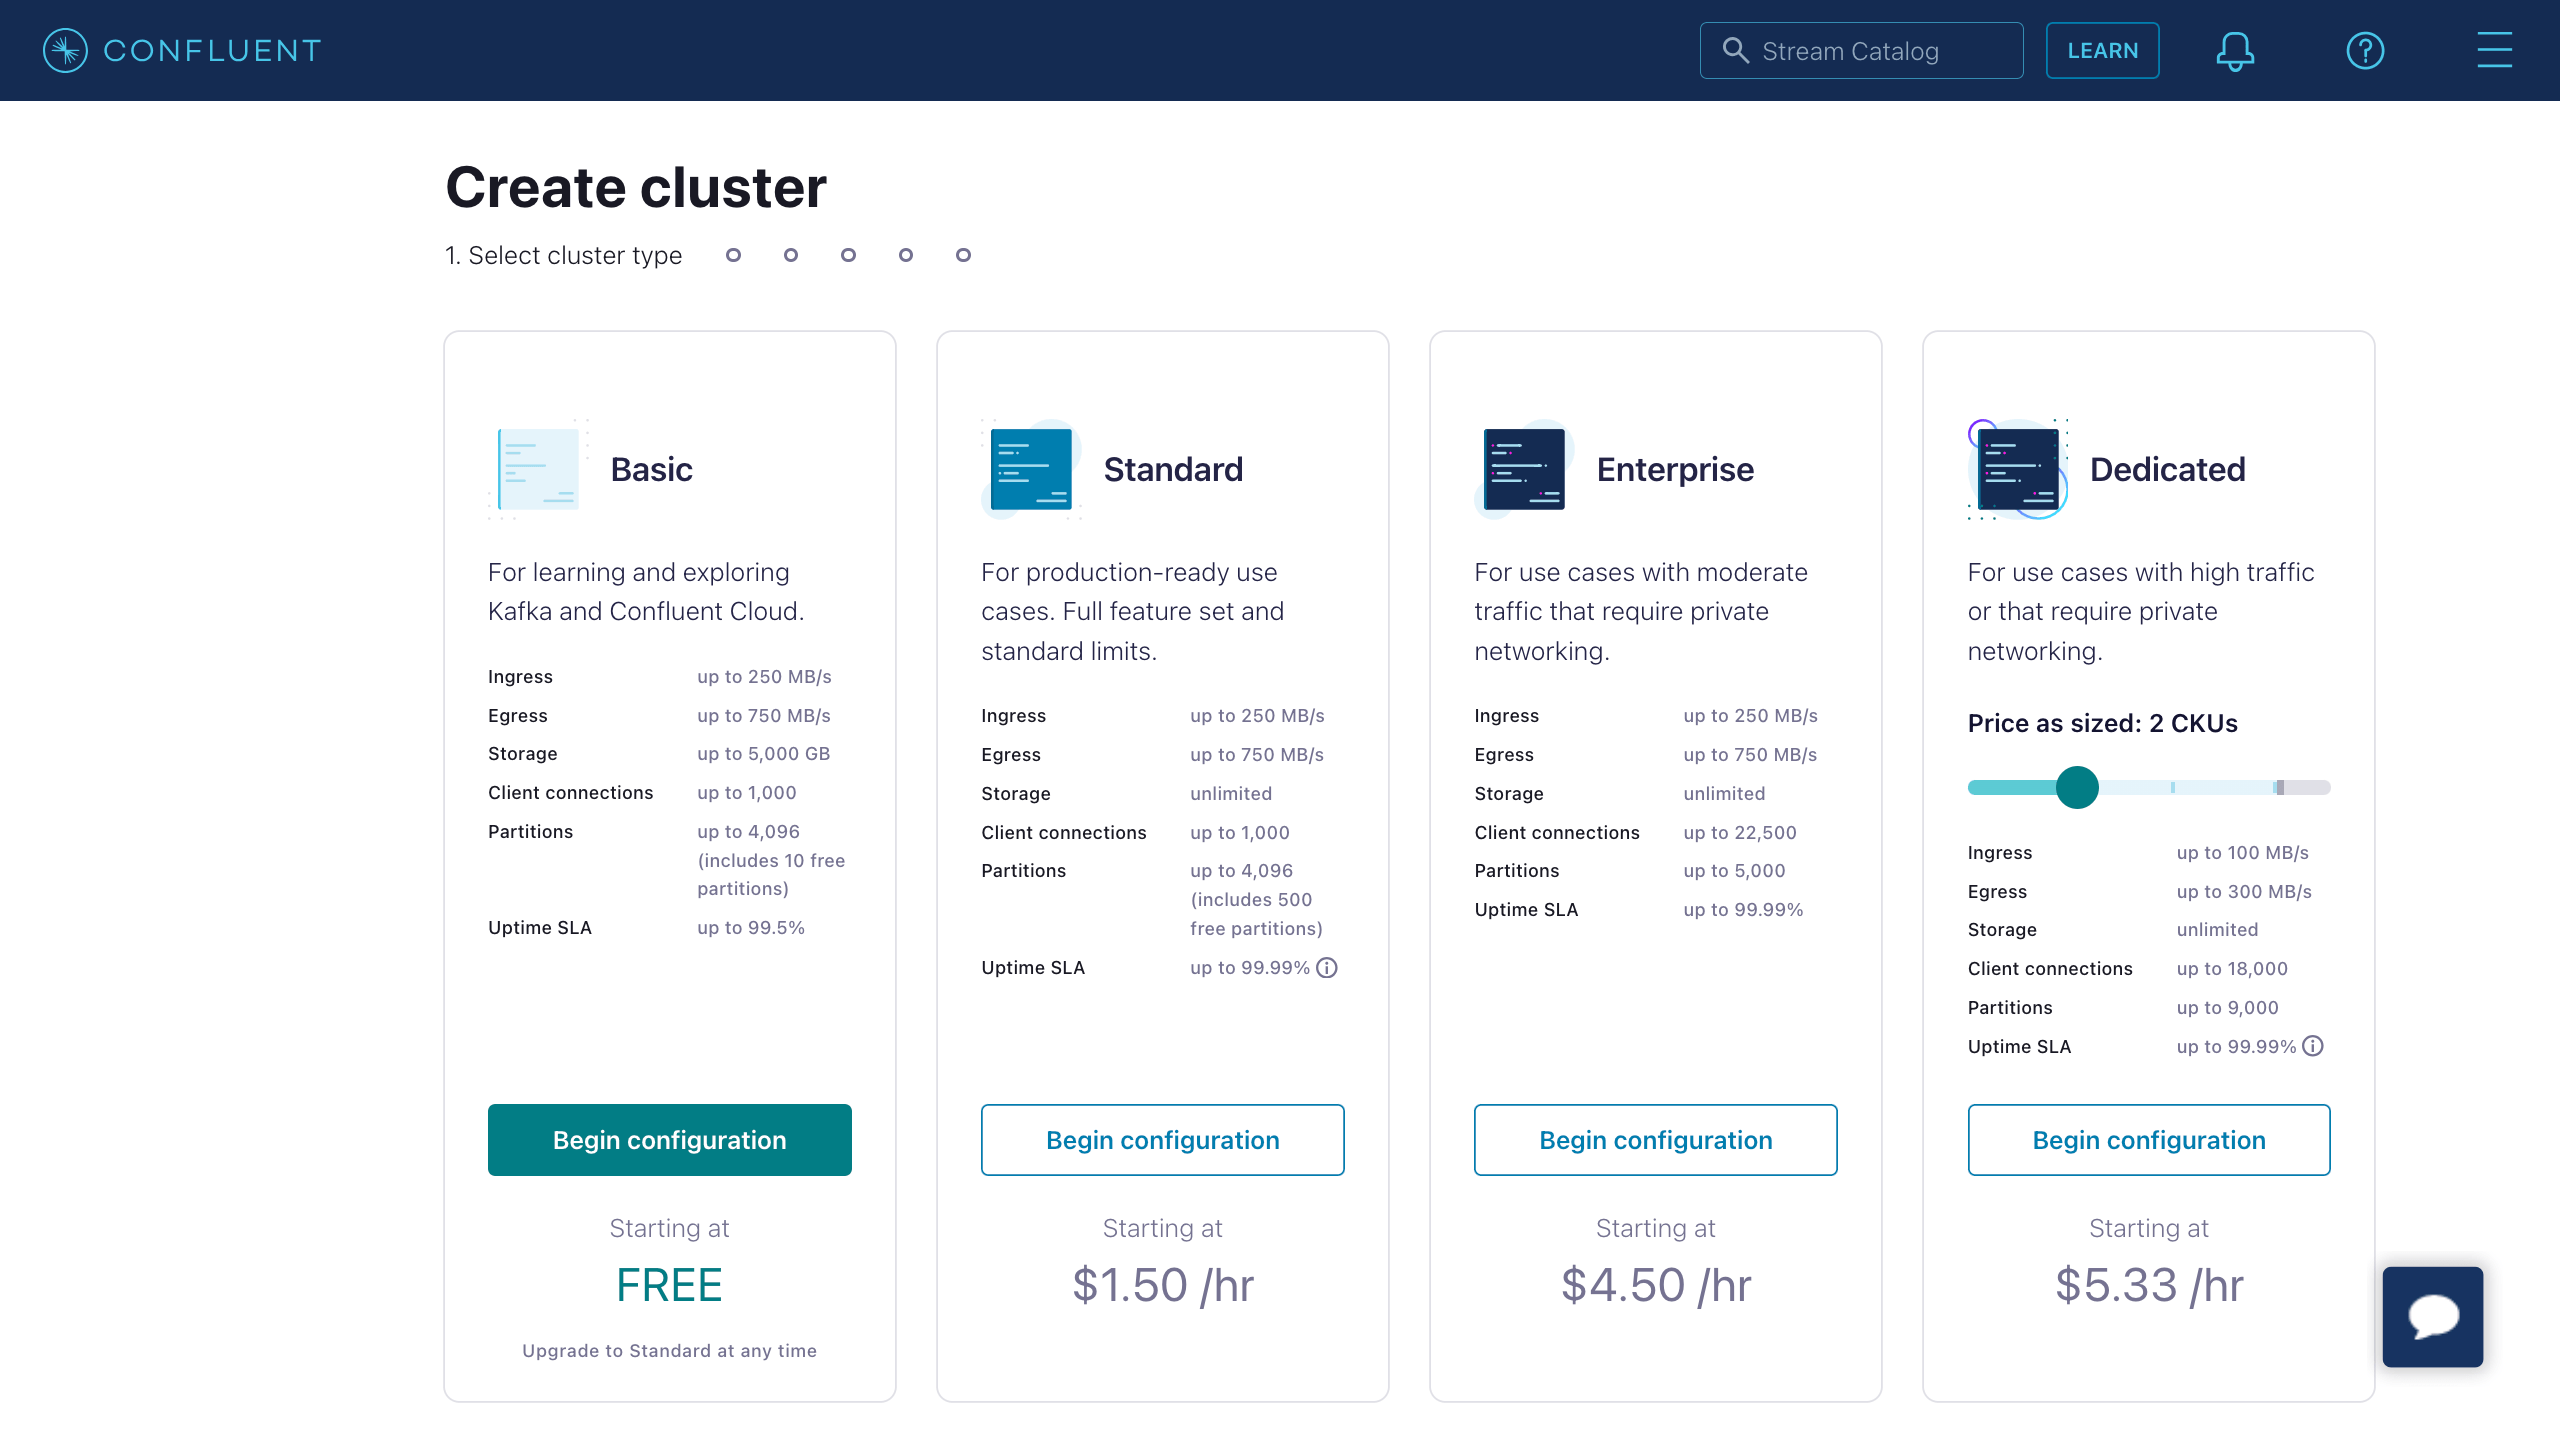
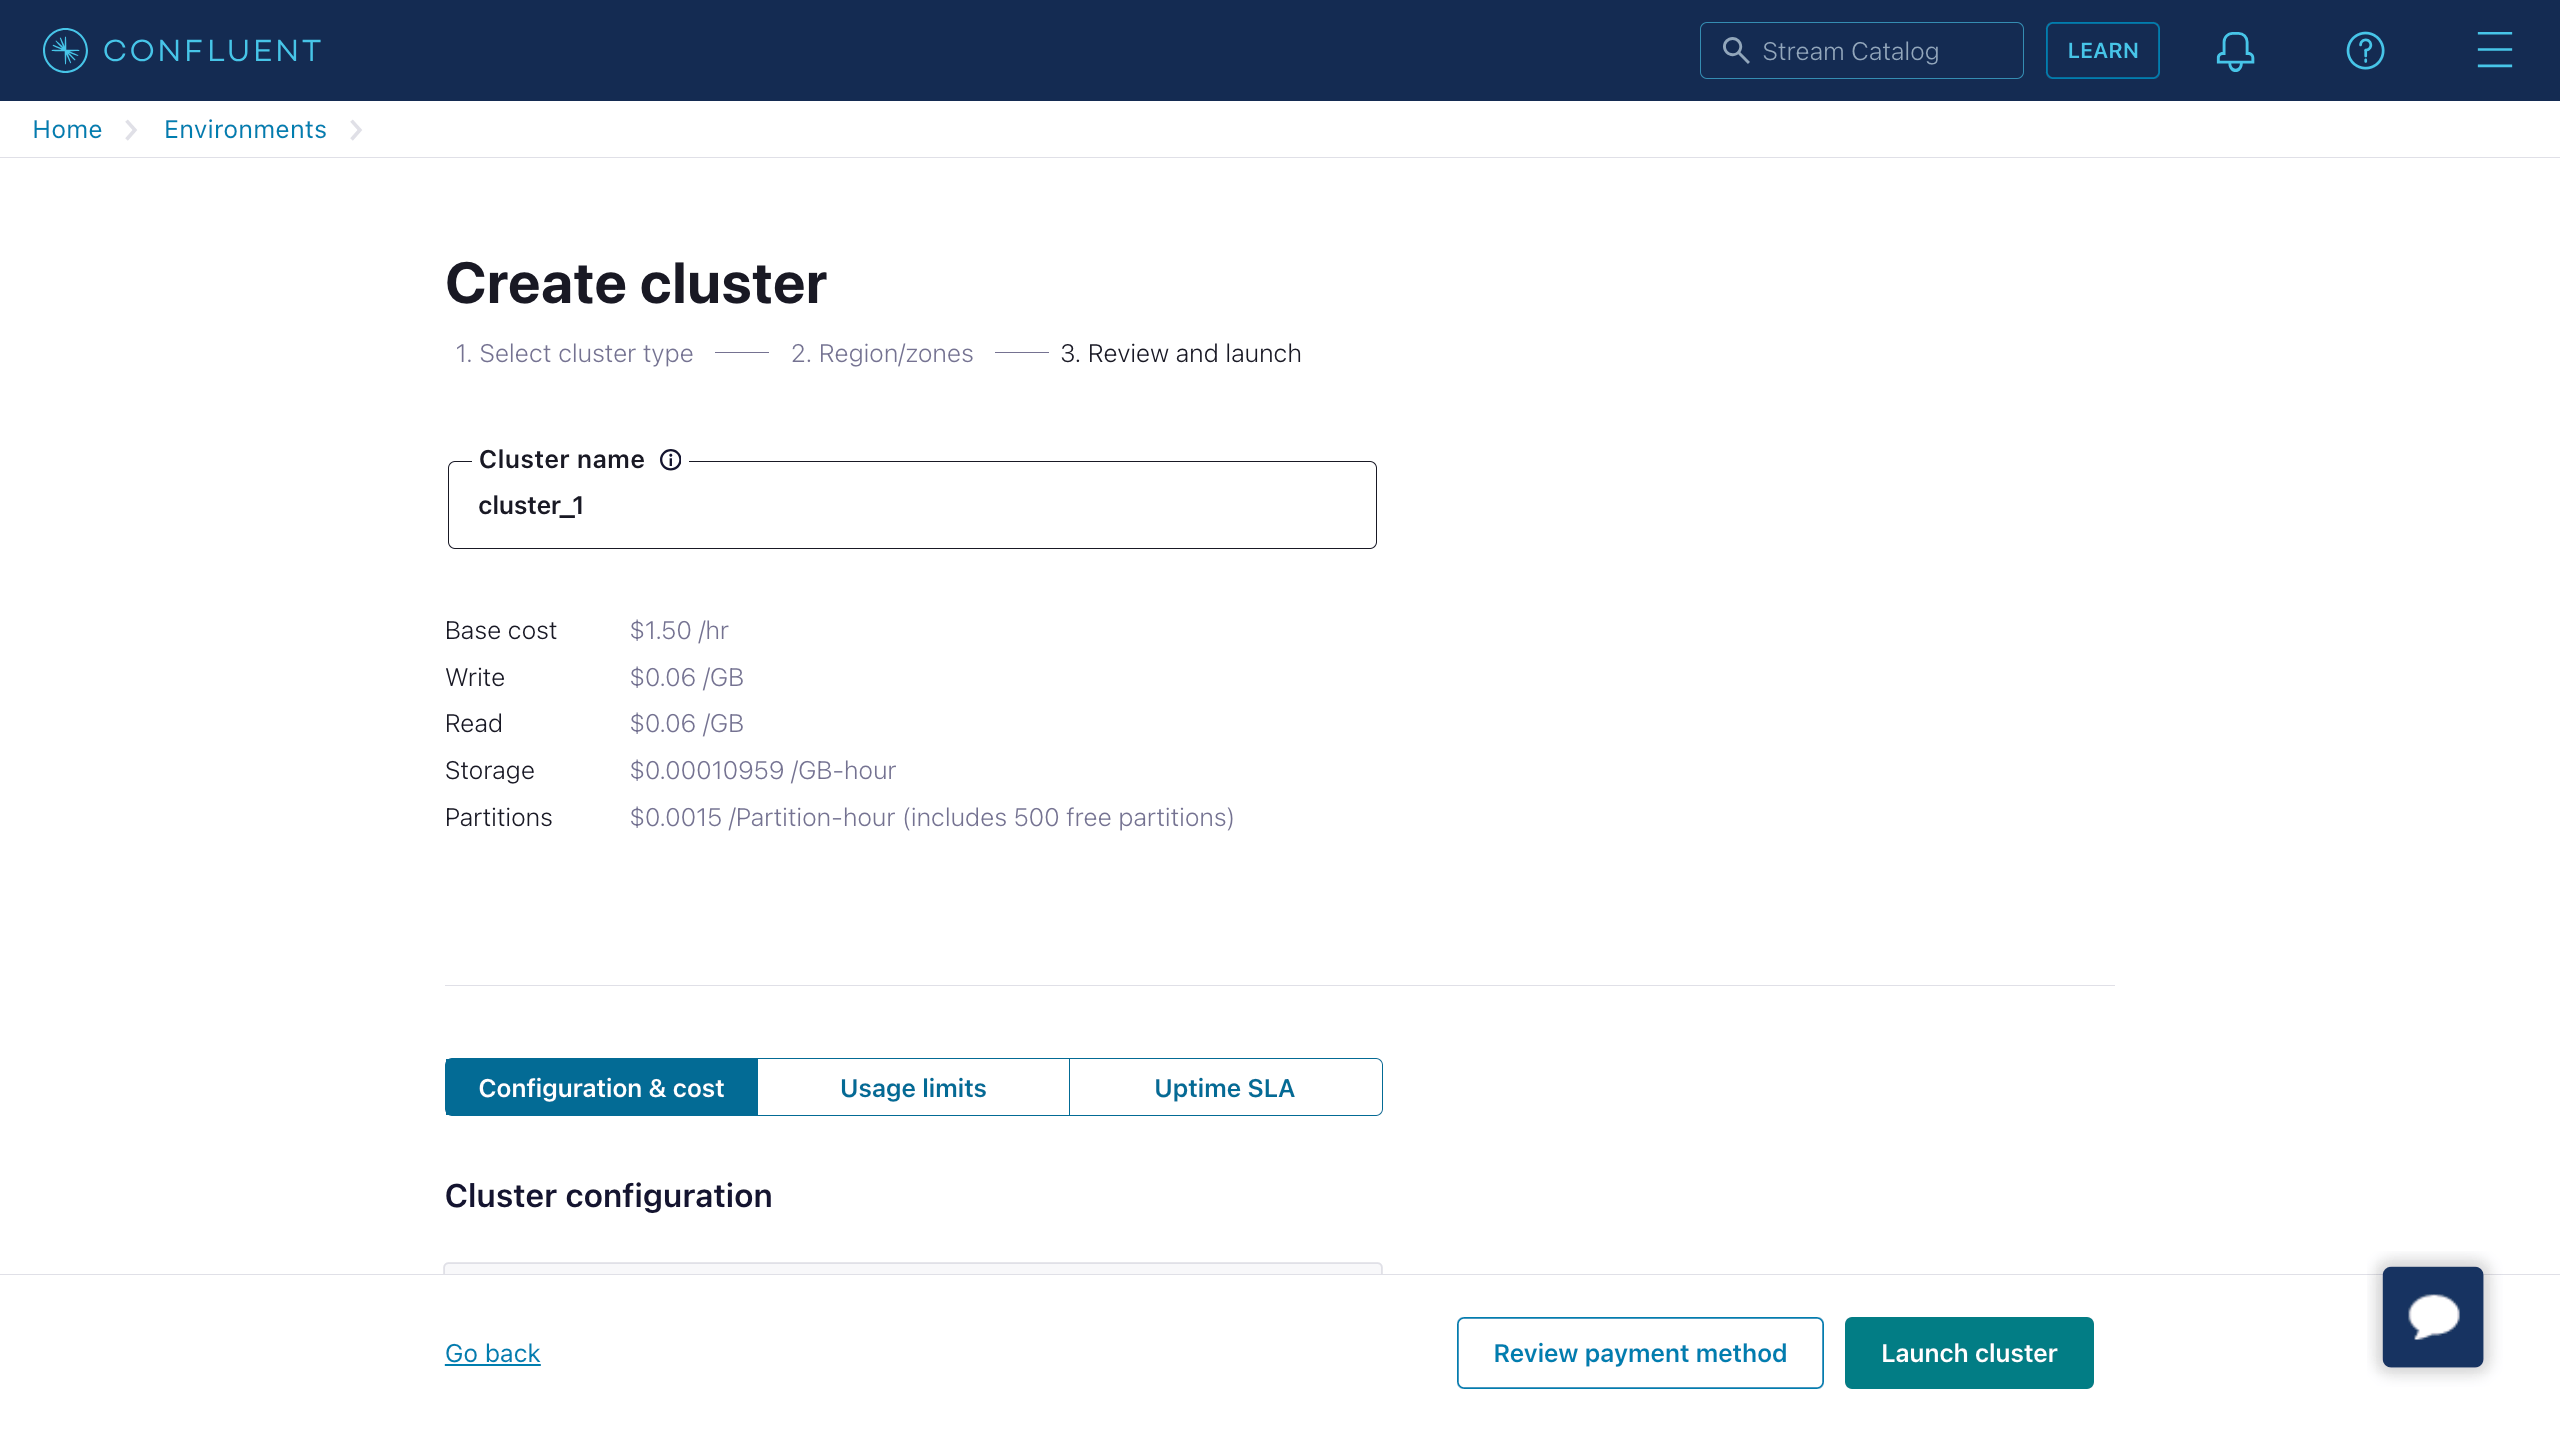
- Confluent Cloudコンソールにログインし、クラスターを作成します。例としてStandardクラスターを選択し、Begin configurationをクリックします。
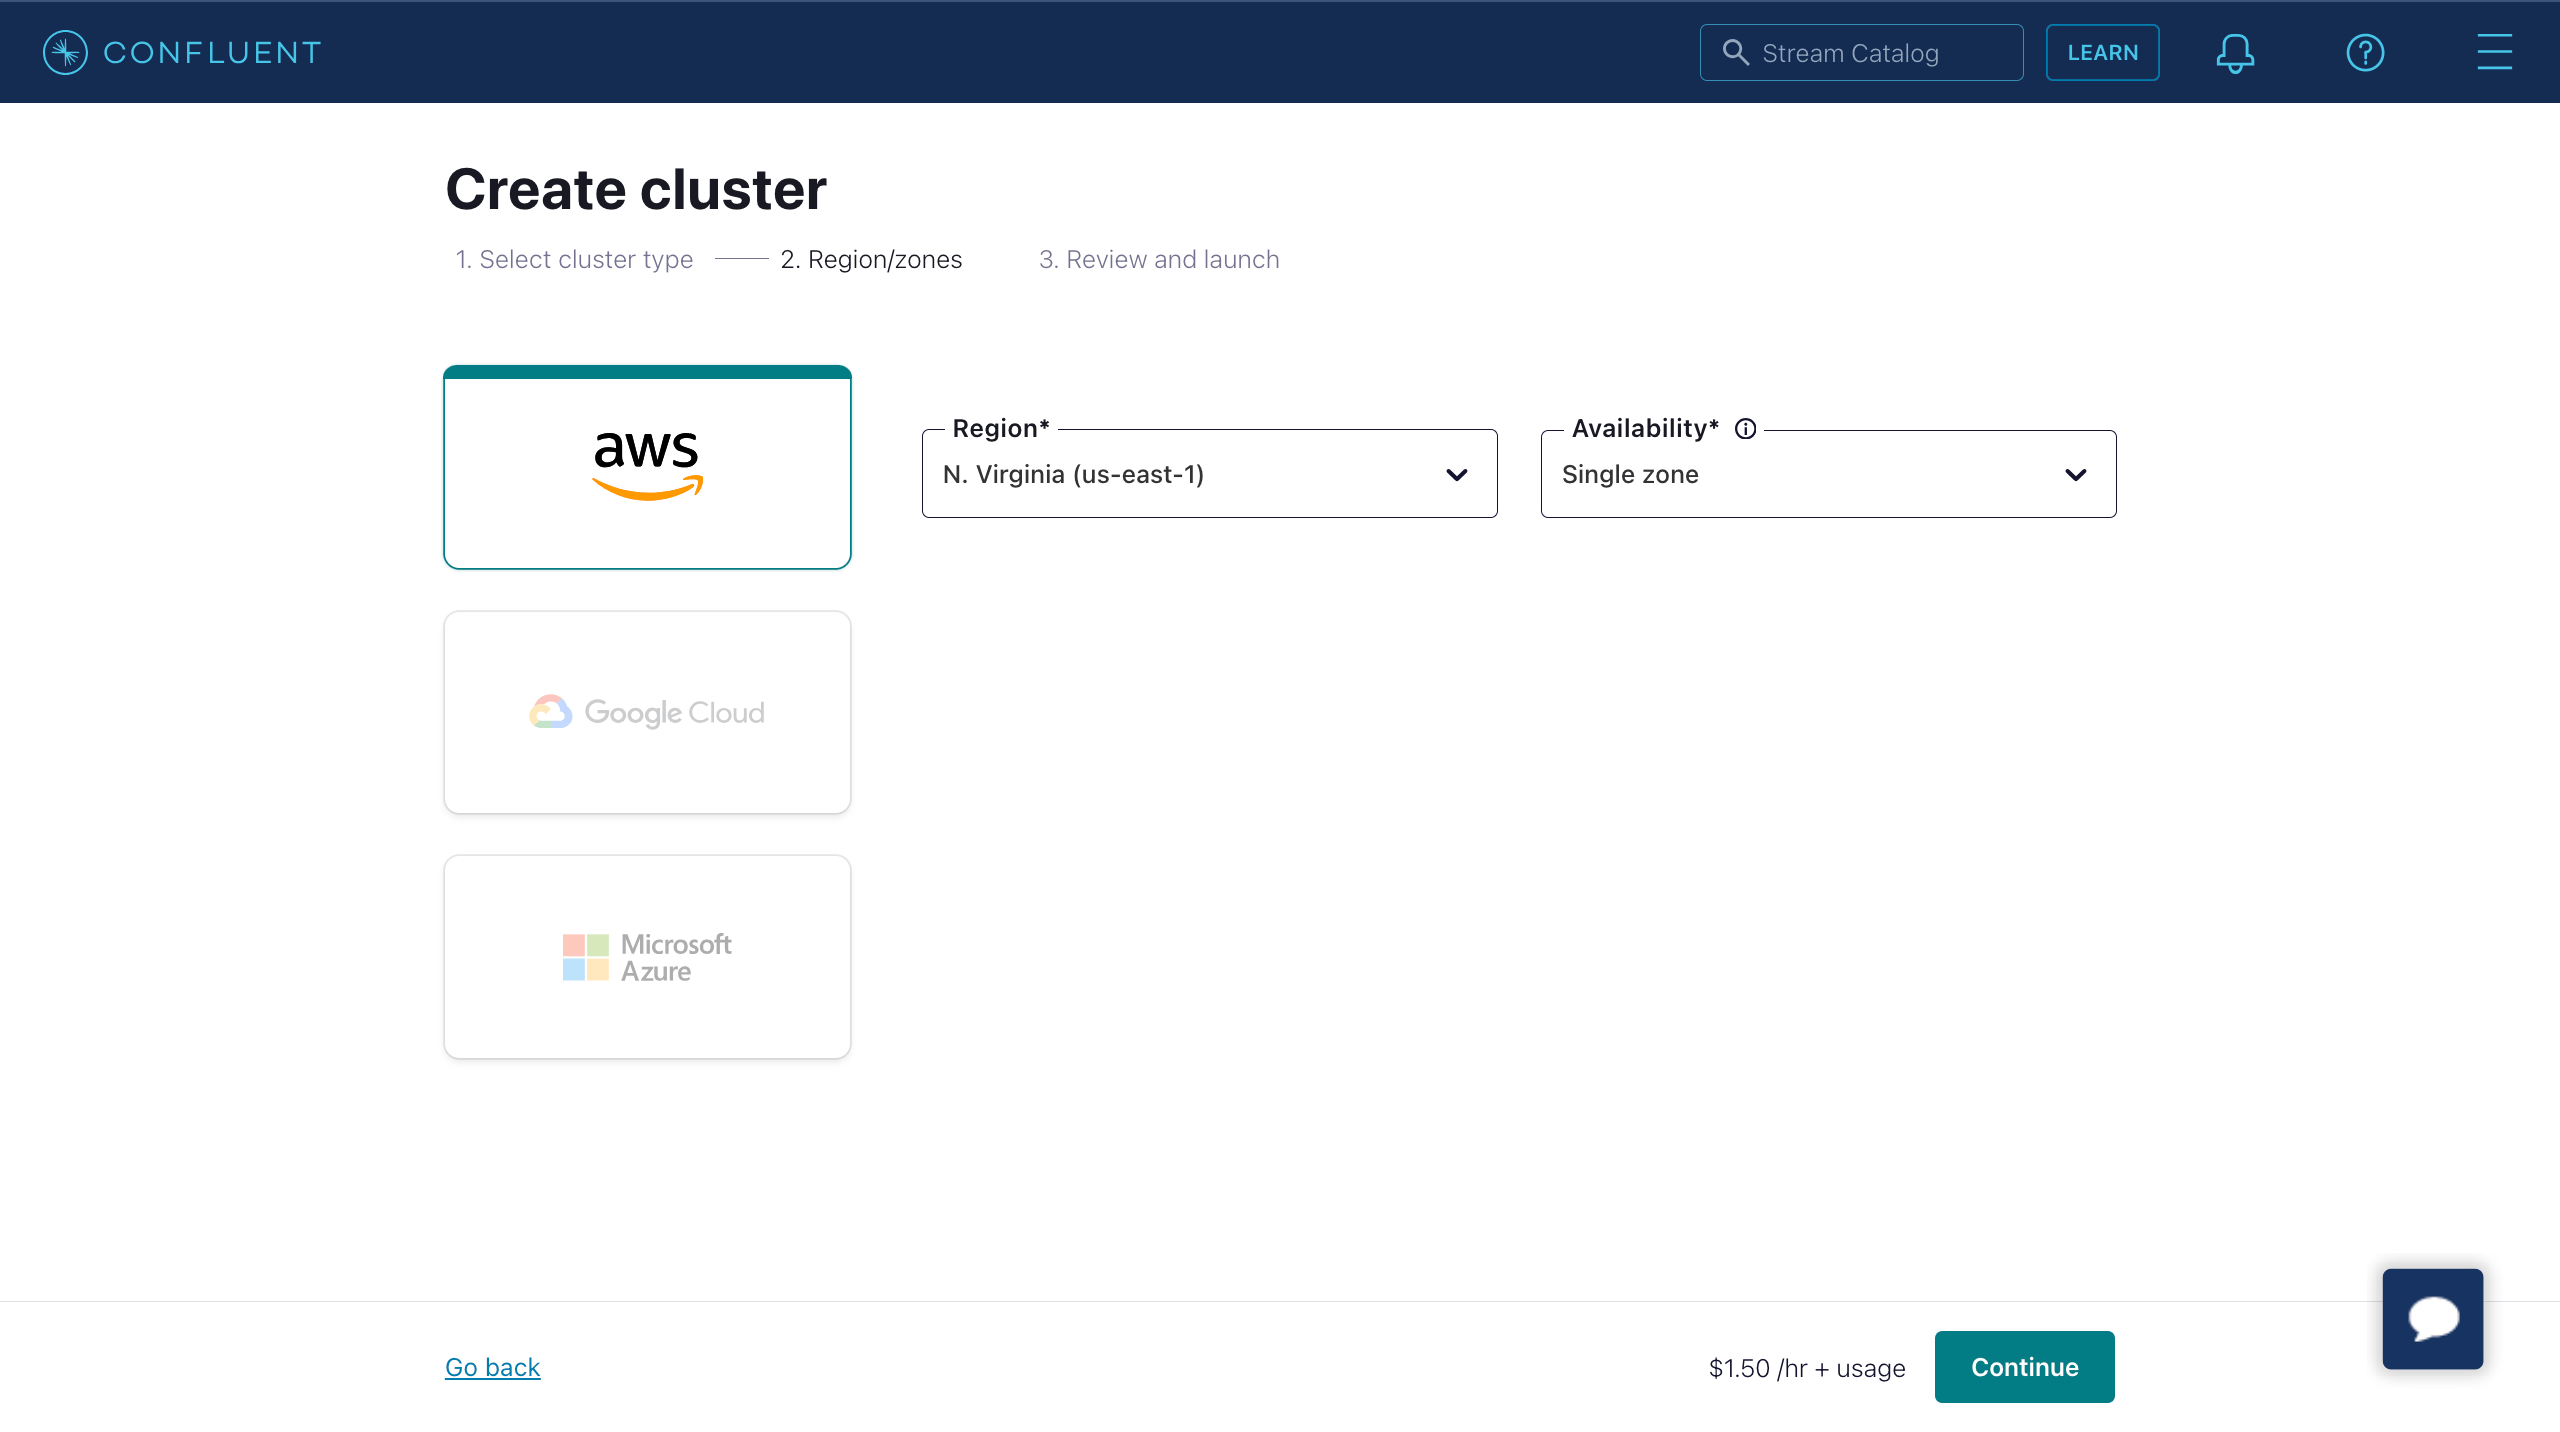
- リージョン/ゾーンを選択します。デプロイメントリージョンがConfluent Cloudのリージョンと一致していることを確認し、Continueをクリックします。
- クラスター名を入力し、Launch clusterをクリックします。
Confluent Cloud CLIを使ったトピックとAPIキーの作成
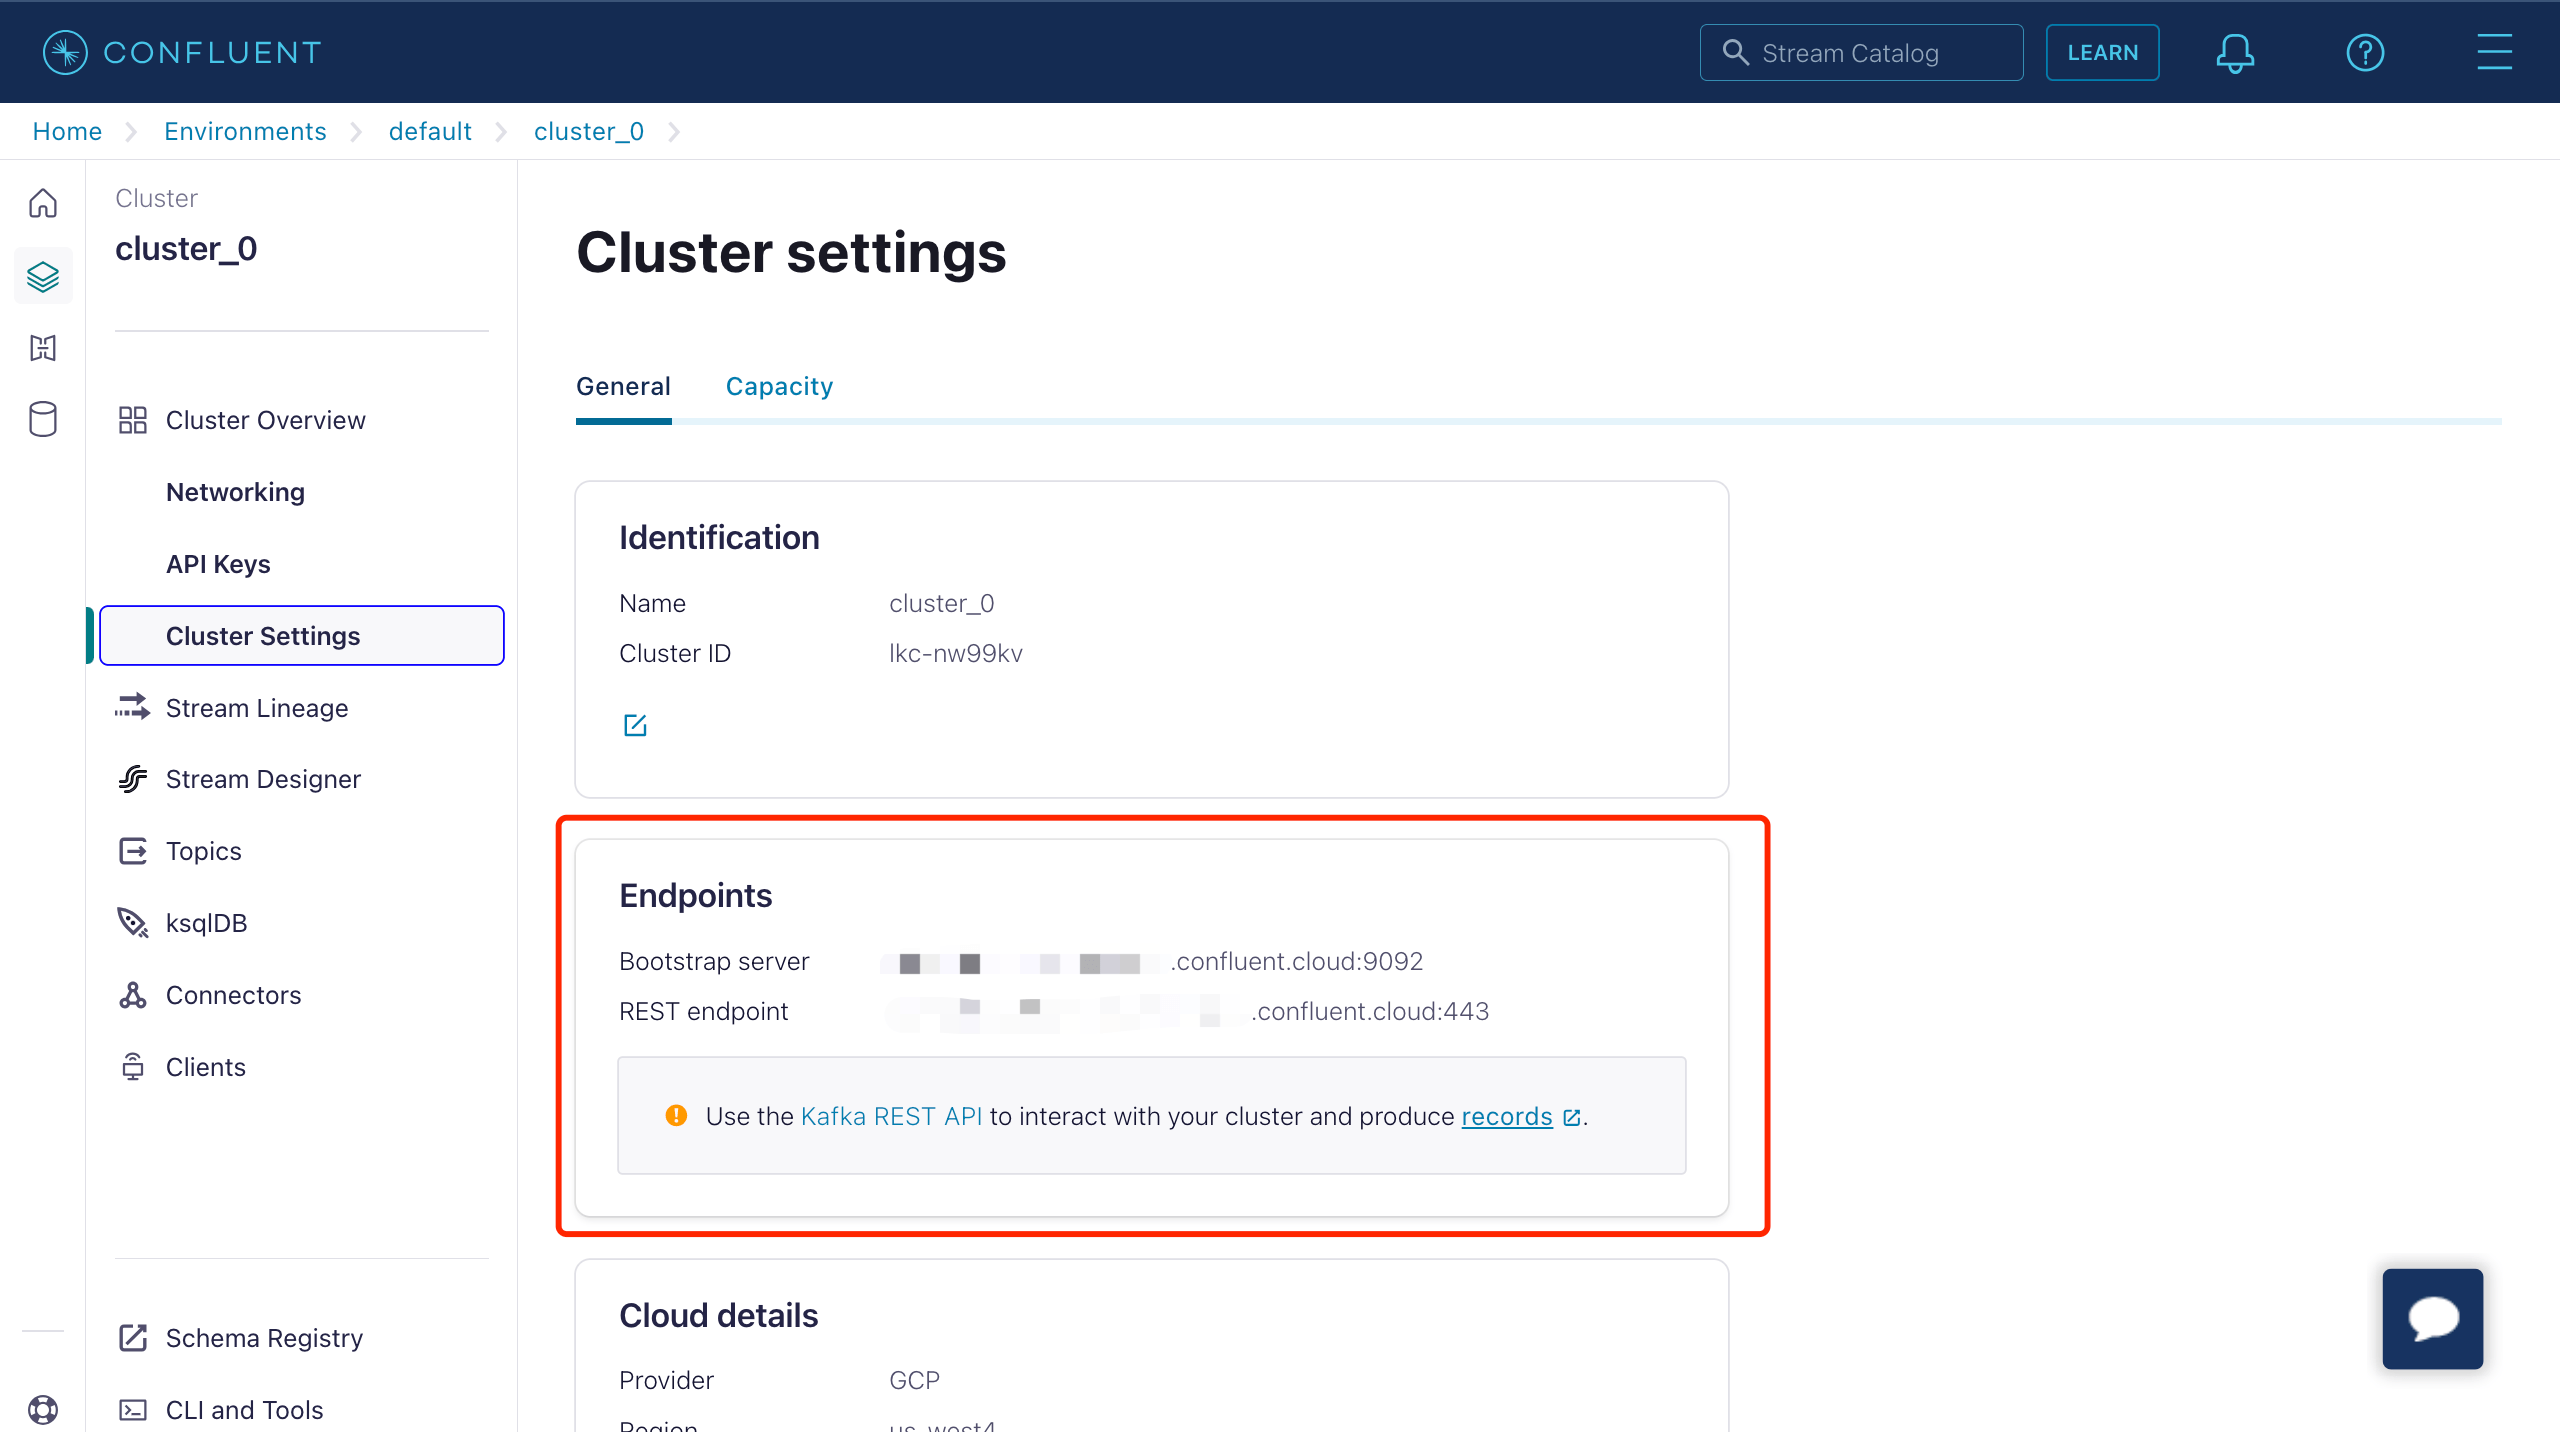
クラスターがConfluent Cloudで稼働したら、Cluster Overview -> Cluster SettingsページからBootstrap serverのURLを取得できます。
Confluent Cloud CLIを使ってクラスターを管理できます。以下は基本的なCLIコマンドです。
Confluent Cloud CLIのインストール
curl -sL --http1.1 https://cnfl.io/cli | sh -s -- -b /usr/local/bin既にインストール済みの場合は、以下のコマンドでアップデート可能です。
confluent updateアカウントにログイン
confluent login --save環境を選択
# 環境一覧表示
confluent environment list
# 環境選択
confluent environment use <environment_id>
クラスターを選択
# Kafkaクラスター一覧表示
confluent kafka cluster list
# Kafkaクラスター選択
confluent kafka cluster use <kafka_cluster_id>
APIキーとシークレットの使用
既存のAPIキーを使う場合は、以下のコマンドでCLIに追加します。
confluent api-key store --resource <kafka_cluster_id>
Key: <API_KEY>
Secret: <API_SECRET>
APIキーとシークレットを持っていない場合は、以下のコマンドで作成できます。
$ confluent api-key create --resource <kafka_cluster_id>

APIキーの準備には数分かかる場合があります。
APIキーとシークレットは保存してください。シークレットは後で取得できません。
+------------+------------------------------------------------------------------+
| API Key    | YZ6R7YO6Q2WK35X7                                                 |
| API Secret | ****************************************                         |
+------------+------------------------------------------------------------------+
CLIに追加後、以下のコマンドでAPIキーとシークレットを使用できます。
confluent api-key use <API_Key> --resource <kafka_cluster_id>トピックの作成
testtopic-inという名前のトピックを以下のコマンドで作成できます。
confluent kafka topic create testtopic-inトピック一覧は以下のコマンドで確認可能です。
confluent kafka topic listトピックへのメッセージ送信(Producer)
以下のコマンドでプロデューサーを作成できます。起動後、メッセージを入力してEnterを押すと、該当トピックにメッセージが送信されます。
confluent kafka topic produce testtopic-inトピックからのメッセージ受信(Consumer)
以下のコマンドでコンシューマーを作成できます。該当トピック内のすべてのメッセージが出力されます。
confluent kafka topic consume -b testtopic-inコネクターの作成
Confluent Sinkアクションを追加する前に、EMQXとConfluent Cloud間の接続を確立するためにConfluentプロデューサーコネクターを作成する必要があります。
EMQXダッシュボードでIntegration -> Connectorsをクリックします。
ページ右上のCreateをクリックし、コネクター選択ページでConfluent Producerを選択してNextをクリックします。
my-confluentなどの名前と説明を入力します。名前はConfluent Sinkとコネクターを関連付けるために使用され、クラスター内で一意である必要があります。Confluent Cloudへの接続に必要なパラメータを設定します。
Bootstrap Hosts:Confluent Cloudクラスター設定ページのEndpointsセクションにあるエンドポイント情報を入力します。
Authentication:Confluent Cloudクラスターで必要な認証方式を選択します。
Basic auth:Confluent Cloudで作成したAPI KeyとAPI Secretに対応するUsernameとPasswordを入力します。
OAuth:Confluent CloudのOAuth/OIDC設定に従い、トークンエンドポイント、クライアントID、クライアントシークレットなどのOAuthパラメータを設定します。
OAuth設定はKafkaコネクターと同様です。各パラメータの詳細は認証方式を参照してください。
Request Timeout:EMQXがConfluentからの応答を待つ最大時間(秒)を指定します。デフォルトは
30秒です。タイムアウトを超えるとEMQXは接続が切れたとみなし再接続を試みます。この値が小さすぎると、Confluentはプロデュース要求を受け付けても応答を遅延させる場合があり、EMQXは再接続後に同じバッチを再送するため、重複メッセージや下流の過剰なデータ量を招く恐れがあります。その他のオプションはデフォルトのままか、ビジネスニーズに応じて設定してください。
Createボタンをクリックしてコネクターの作成を完了します。
作成後、コネクターは自動的にConfluent Cloudに接続します。次に、このコネクターを基にルールを作成し、コネクターで設定したConfluentクラスターへデータを転送します。
Confluent Sinkを使ったルールの作成
このセクションでは、MQTTトピックt/#のメッセージを処理し、処理結果を設定済みのConfluent Sinkを使ってConfluentのtesttopic-inトピックに送信するルールの作成方法を示します。
EMQXダッシュボードに入り、Integration -> Rulesをクリックします。
右上のCreateをクリックします。
ルールIDとして
my_ruleなどを入力します。MQTTメッセージをトピック
t/#からConfluentに転送したい場合、SQL Editorに以下の文を入力します。注意:独自のSQL構文を指定する場合は、
SELECT部にSinkが必要とするすべてのフィールドが含まれていることを確認してください。sqlSELECT * FROM "t/#"注意:初心者の場合はSQL ExampleやEnable TestをクリックしてSQLルールの学習やテストが可能です。
- Add Actionボタンをクリックし、ルールでトリガーされるアクションを定義します。Type of Actionのドロップダウンリストから
Confluent Producerを選択し、ActionドロップダウンはデフォルトのCreate Actionのままにするか、既存のConfluent Producerアクションを選択します。この例では新規ルールを作成し、ルールに追加します。
- Add Actionボタンをクリックし、ルールでトリガーされるアクションを定義します。Type of Actionのドロップダウンリストから
Sinkの名前と説明を対応するテキストボックスに入力します。
Connectorドロップダウンから先ほど作成した
my-confluentコネクターを選択します。ドロップダウン横のボタンをクリックすると、ポップアップで新規コネクターを素早く作成可能です。必要な設定パラメータはコネクターの作成を参照してください。Sinkのデータ送信方法を設定します。
- Kafka Topic:
testtopic-inを入力します。EMQX v5.7.2以降、このフィールドは動的トピック設定もサポートします。詳細はKafka動的トピックの設定を参照してください。 - Kafka Headers:Kafkaメッセージに関連するメタデータやコンテキスト情報を入力します(任意)。プレースホルダーの値はオブジェクトである必要があります。ヘッダー値のエンコードタイプはKafka Header Value Encod Typeのドロップダウンから選択可能です。Addをクリックしてキー・バリューのペアを追加できます。
- Message Key:Kafkaメッセージのキーです。純粋な文字列かプレースホルダー(${var})を含む文字列を入力できます。
- Message Value:Kafkaメッセージの値です。純粋な文字列かプレースホルダー(${var})を含む文字列を入力できます。
- Partition Strategy:プロデューサーがKafkaのパーティションにメッセージを分配する方法を選択します。
- Compression:Kafkaメッセージ内のレコードを圧縮/解凍するための圧縮アルゴリズムの使用有無を指定します。
- Kafka Topic:
フォールバックアクション(任意):メッセージ配信失敗時の信頼性向上のため、1つ以上のフォールバックアクションを定義可能です。プライマリSinkがメッセージ処理に失敗した場合にこれらのアクションがトリガーされます。詳細はフォールバックアクションを参照してください。
詳細設定(任意):詳細設定を参照してください。
CreateボタンをクリックしてSinkの作成を完了します。作成後、ページはCreate Ruleに戻り、新規Sinkがルールアクションに追加されます。
Createボタンをクリックしてルール全体の作成を完了します。
これでルールが正常に作成され、Integration -> Rulesページで新規ルールを確認でき、**Actions(Sink)**タブで新規Confluent Producer Sinkも確認できます。
また、Integration -> Flow Designerをクリックするとトポロジーを確認できます。トポロジーを通じて、トピックt/#のメッセージがルールmy_ruleで解析され、Confluentに送信・保存されている様子を直感的に把握できます。
Confluent Producerルールのテスト
Confluent Producerルールが期待通りに動作するかテストするため、MQTTXを使ってクライアントがEMQXにMQTTメッセージをパブリッシュする動作をシミュレートできます。
MQTTXを使い、トピック
t/1にメッセージを送信します。bashmqttx pub -i emqx_c -t t/1 -m '{ "msg": "Hello Confluent" }'**Actions(Sink)**ページでSinkの名前をクリックし統計情報を表示します。Sinkの稼働状況を確認し、新規の受信メッセージ数と送信メッセージ数が1件ずつ増えていることを確認します。
以下のConfluentコマンドで
testtopic-inトピックにメッセージが書き込まれているか確認します。bashconfluent kafka topic consume -b testtopic-in
詳細設定
このセクションでは、コネクターやSink/Sourceのパフォーマンスを最適化し、特定シナリオに応じたカスタマイズ操作を行うための詳細設定オプションを説明します。該当オブジェクト作成時に詳細設定を展開し、ビジネスニーズに応じて以下の設定を行えます。
コネクター設定
| 項目 | 説明 | 推奨値 |
|---|---|---|
| Allow Auto Topic Creation | (Producerのみ)有効にすると、クライアントがメタデータ取得要求を送信した際にKafkaトピックが存在しなければ自動作成を許可します。 | Disabled |
| Connect Timeout | TCP接続確立の最大待機時間。認証有効時は認証時間も含みます。 | 5秒 |
| Start Timeout | コネクターが自動起動したリソースの正常状態到達を待つ最大秒数。これによりSinkは接続先リソース(例:Confluentクラスター)が完全稼働しデータ処理可能になるまで操作を進めません。 | 5秒 |
| Health Check Interval | コネクターの稼働状態をチェックする間隔時間。 | 15秒 |
| Min Metadata Refresh Interval | Kafkaブローカーやトピックのメタデータを更新する最小間隔時間。短すぎるとKafkaサーバーに不要な負荷をかける可能性があります。 | 3秒 |
| Metadata Request Timeout | Kafkaからメタデータを取得する際の最大待機時間。 | 5秒 |
| Socket Send / Receive Buffer Size | ネットワーク伝送性能を最適化するためのソケットバッファサイズ。 | 1MB |
| No Delay | システムカーネルがTCPソケットを即時送信するか遅延送信するかを選択。トグルをオンにすると即時送信されます。オフの場合、送信内容が少ないと40ミリ秒程度の遅延が発生します。 | Enabled |
| TCP Keepalive | Kafkaブリッジ接続のTCPキープアライブ機能を有効にし、長時間の非アクティブ状態による接続切断を防止します。値はIdle, Interval, Probesの3つの数値のカンマ区切りで指定します。Idle: 接続がアイドル状態でキープアライブを開始するまでの秒数(Linuxのデフォルトは7200秒)。 Interval: キープアライブプローブ間の秒数(Linuxのデフォルトは75秒)。 Probes: 応答なしと判断するまでの最大プローブ数(Linuxのデフォルトは9回)。 例: 240,30,5は240秒のアイドル後に30秒間隔で5回プローブを送信し応答がなければ接続切断と判断します。 | none |
Confluent Producer Sink設定
| 項目 | 説明 | 推奨値 |
|---|---|---|
| Health Check Interval | Sinkの稼働状態をチェックする間隔時間。 | 15秒 |
| Max Batch Bytes | Kafkaバッチ内でメッセージを収集する最大サイズ(バイト)。Kafkaブローカーのデフォルトは1MBですが、EMQXはKafkaメッセージのエンコードオーバーヘッドを考慮し、特に小さいメッセージが多い場合に備えて1MBよりやや小さく設定しています。単一メッセージがこの制限を超える場合は別バッチとして送信されます。 | 896KB |
| Required Acks | Kafkaパーティションリーダーがフォロワーから待機する確認応答の種類:all_isr: 全てのインシンクレプリカからの応答を要求。leader_only: パーティションリーダーのみ応答を要求。none: Kafkaからの応答は不要。 | all_isr |
| Partition Count Refresh Interval | Kafkaプロデューサーがパーティション数の増加を検知する間隔時間。Kafkaのパーティション数が増加すると、EMQXは指定されたpartition_strategyに基づき新しいパーティションをメッセージ送信に組み込みます。 | 60秒 |
| Max Inflight | KafkaプロデューサーがKafkaからのアックを受け取る前に送信可能な最大バッチ数(パーティション毎)。値が大きいほどスループットは向上しますが、1より大きい場合はメッセージの順序が入れ替わるリスクがあります。未確認メッセージ数を制御し、システム負荷のバランスを取ります。 | 10秒 |
| Query Mode (Producer) | 非同期または同期のクエリモードを選択し、要件に応じてメッセージ送信を最適化します。非同期モードではKafkaへの書き込みがMQTTメッセージのパブリッシュ処理をブロックしませんが、クライアントがKafka到着前にメッセージを受信する可能性があります。 | Async |
| Synchronous Query Timeout | 同期クエリモード時の最大待機時間。メッセージ送信完了を適時保証し、長時間待機を防止します。ブリッジのクエリモードがSyncに設定されている場合のみ適用されます。 | 5秒 |
| Buffer Mode | メッセージを送信前にバッファリングするかどうかを定義します。メモリバッファリングは送信速度を向上させます。memory: メモリにバッファリング。EMQXノード再起動時にメッセージは失われます。disk: ディスクにバッファリング。EMQXノード再起動後もメッセージは保持されます。hybrid: 初期はメモリにバッファリングし、一定容量(segment_bytes設定参照)に達すると徐々にディスクにオフロードします。メモリモード同様、EMQXノード再起動時にメッセージは失われます。 | memory |
| Per-partition Buffer Limit | Kafkaパーティション毎の最大バッファサイズ(バイト)。制限に達すると古いメッセージを破棄してバッファ空間を確保します。メモリ使用量と性能のバランス調整に役立ちます。 | 2GB |
| Segment File Bytes | バッファモードがdiskまたはhybridの場合に適用。メッセージ保存に使うセグメントファイルのサイズを制御し、ディスクストレージの最適化に影響します。 | 100MB |
| Memory Overload Protection | バッファモードがmemoryの場合に適用。メモリ使用圧力が高い際に古いバッファメッセージを自動破棄し、過剰なメモリ使用によるシステム不安定化を防止し信頼性を確保します。注:Linuxシステムのみ有効です。 | Disabled |
| Max Batch Age | プロデューサーバッファ内でメッセージが送信されずに保持される最大期間。期限切れのバッチは破棄され、破棄されたメッセージはdropped.expiredメトリクスにカウントされます。切断中にバッファリングされたメッセージや接続喪失時にアック待ちのメッセージが対象です。デフォルトのinfinityはメッセージの期限切れを防ぎます。バッファオーバーフロー時にはメッセージが破棄される場合があります。 | infinity |
| Max Retries | Confluentがリトライ可能なエラー(例:パーティションリーダー変更)を返した場合の最大リトライ回数。初回試行と全リトライが失敗するとバッチは破棄され、各メッセージはfailedメトリクスにカウントされます。リトライ回数は明示的なConfluentエラー応答のみで増加し、接続喪失による再送は増加しません。max_batch_ageで制限されます。デフォルトのinfinityは無制限リトライを許可します。 | infinity |
| Reconnect Delay | 接続喪失後にプロデューサーがConfluentへ再接続を試みるまでの遅延時間。切断中もメッセージはバッファに蓄積され、バッファ制限とmax_batch_ageの影響を受けます。デフォルトは2秒です。 | 2秒 |
| Max Linger Time | パーティション毎のプロデューサーがより大きなバッチを形成するためにメッセージを蓄積する最大待機時間。全バッファモードに適用。デフォルトの0は待機なしでメッセージレイテンシを最適化します。若干の遅延を許容できる場合は設定するとConfluentへのリクエスト数を削減可能です。ディスクバッファリング時はバッファ書き込み前の待機時間であり、IOPS削減のため最低5msの設定推奨です。 | 0ミリ秒 |
| Max Linger Bytes | パーティション毎のプロデューサーが待機を終了しバッチ送信を行う最大バイト数。 | 10MB |
参考情報
EMQXはConfluent/Kafkaとのデータ統合に関する豊富な学習リソースを提供しています。以下のリンクから詳細情報をご覧ください。
ブログ:
- MQTTとKafkaを使ったコネクテッドビークルのストリーミングデータパイプライン構築
- MQTTとKafka|IoTメッセージングとストリームデータ統合の実践
- MQTTパフォーマンスベンチマークテスト:EMQX-Kafka統合
ベンチマークレポート: