RedshiftへのMQTTデータ取り込み
Amazon Redshift は、ペタバイト規模のクラウドデータウェアハウスで、高性能な分析を目的にフルマネージドで提供されています。PostgreSQLをベースにし、オンライン分析処理(OLAP)に最適化されており、複雑なクエリや大規模なデータ分析を高速に実行できます。EMQXはAmazon Redshiftと直接統合し、IoTデバイスからのMQTTテレメトリをほぼリアルタイムで取り込み、保存できます。
本ページでは、EMQXとRedshift間のデータ統合について包括的に解説し、データ統合の作成および検証手順を実践的に説明します。
動作概要
EMQXのRedshiftデータ統合は組み込み機能であり、MQTTベースのIoTデータストリームをAmazon Redshiftの分散型PostgreSQL互換データウェアハウスに直接取り込みます。EMQXの組み込みルールエンジンを使うことで、複雑なカスタムコードを書かずにIoTデータをRedshiftにストリーミングし、大規模な分析処理が可能です。
以下の図は、EMQXとRedshift間の典型的なデータ統合アーキテクチャを示しています。
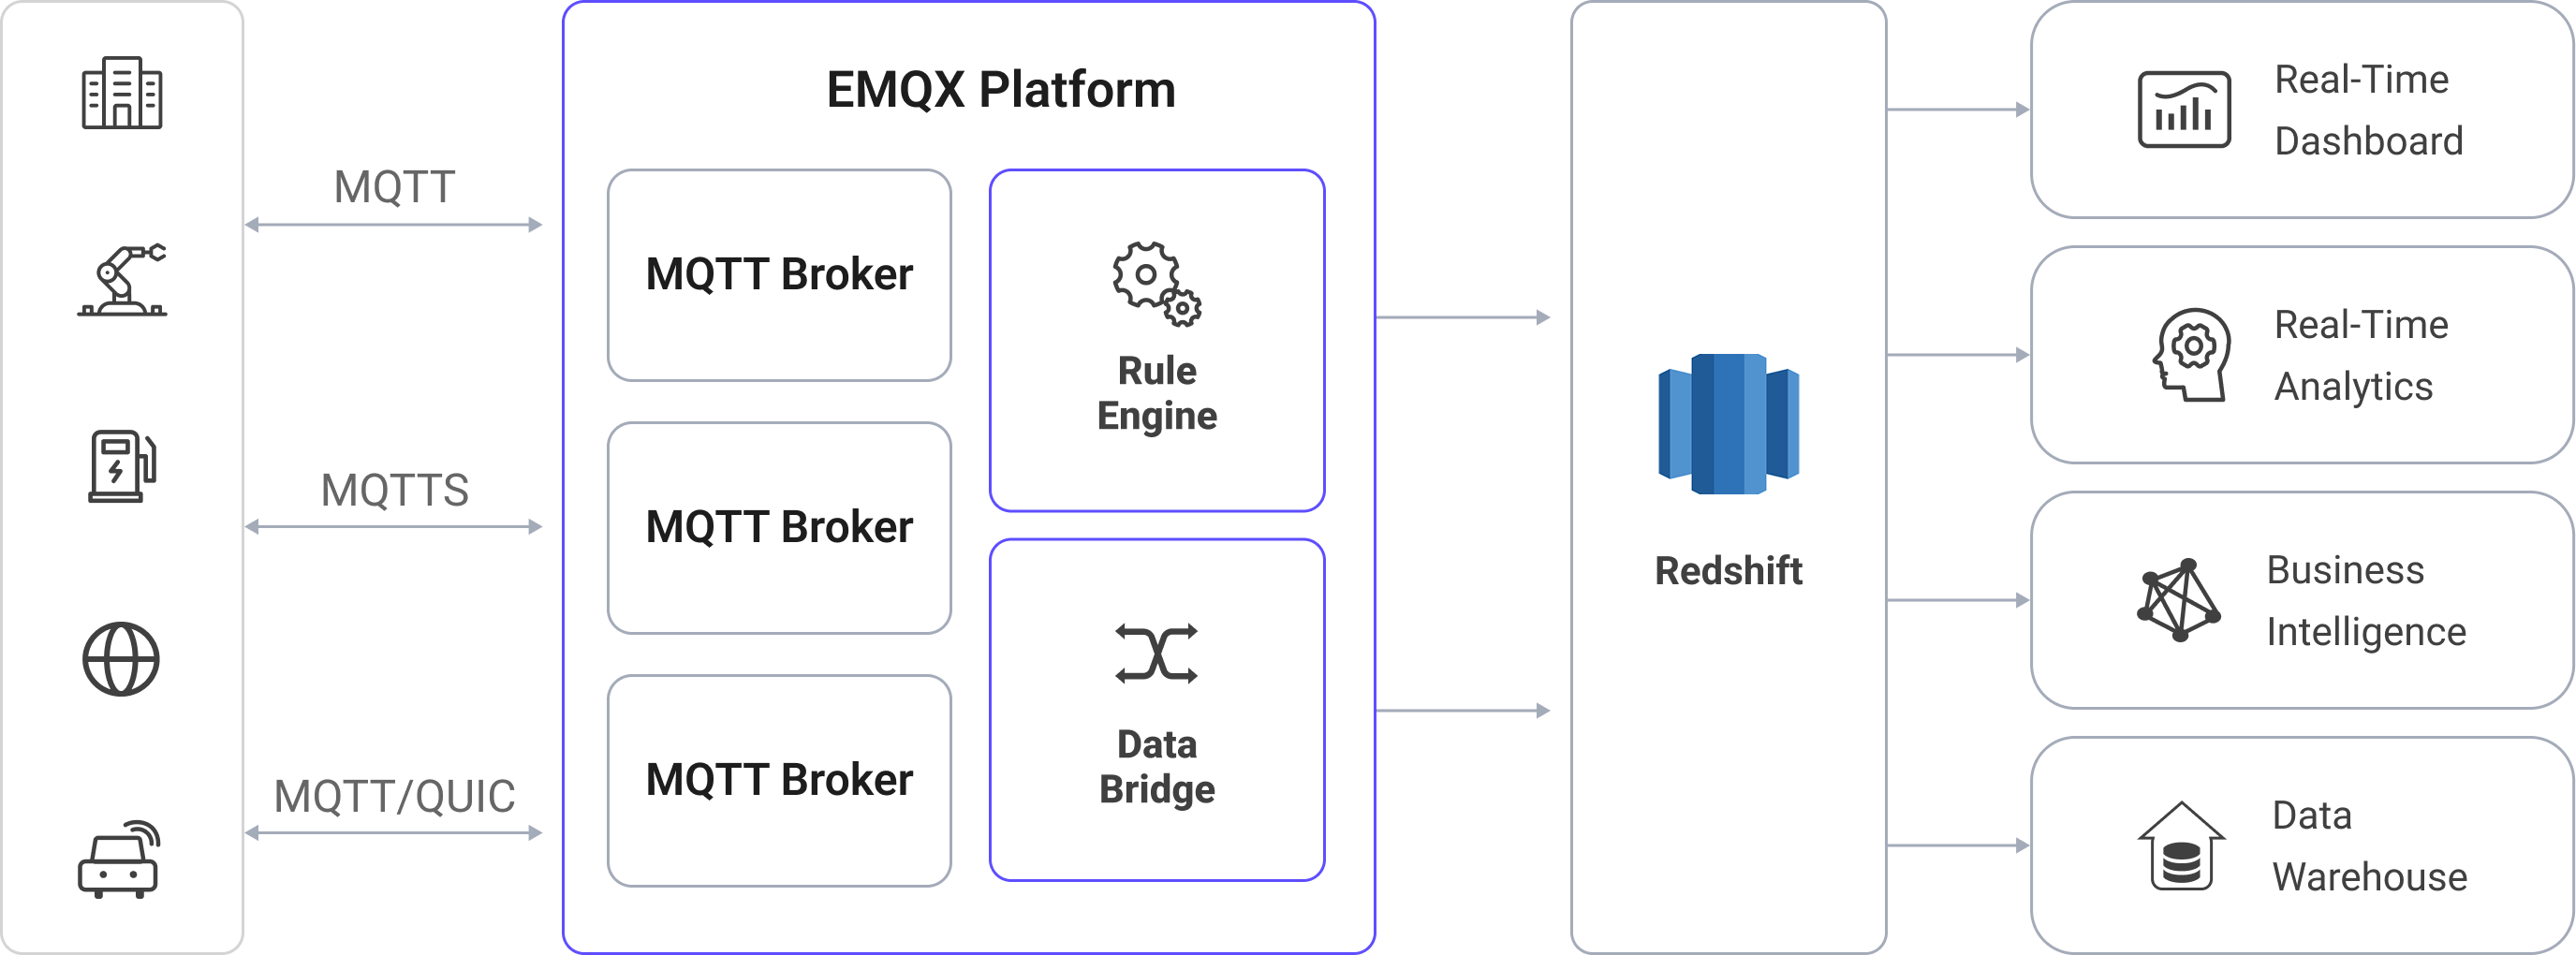
RedshiftへのMQTTデータ取り込みは以下のように動作します:
- IoTデバイスがEMQXに接続:IoTデバイスがMQTTプロトコルを通じて正常に接続されると、オンラインイベントがトリガーされます。イベントにはデバイスID、送信元IPアドレス、その他属性情報が含まれます。
- メッセージのパブリッシュと受信:デバイスはテレメトリやステータスデータを特定のトピックにパブリッシュします。EMQXはこれらのメッセージを受信すると、ルールエンジン内でマッチング処理を開始します。
- ルールエンジンによるメッセージ処理:EMQXのルールエンジンは、トピックやメッセージ内容に基づいて定義されたルールとイベント・メッセージを照合し処理します。処理内容には、データ変換(例:JSONからSQL用フォーマットへの変換)、フィルタリング、コンテキスト情報によるデータ強化などが含まれ、データベース挿入前に行われます。
- Redshiftへの書き込み:マッチしたルールはSQLベースの取り込みをトリガーします。SQLテンプレートを用いて、EMQXは処理済みデータのフィールドをRedshiftのテーブル・カラムにマッピングします。高スループットの取り込みには、Amazon S3からのCOPYやRedshiftストリーミング取り込みを活用し、カラムナストアに効率的にロードします。RedshiftのクエリオプティマイザーとMPP(Massively Parallel Processing)実行エンジンにより、データは即座に分析クエリに利用可能となります。
イベントおよびメッセージデータがRedshiftに書き込まれた後は、以下が可能です:
- Amazon QuickSight、Grafana、TableauなどのツールとRedshiftを接続し、IoTメトリクスやトレンドを追跡するダッシュボードを構築。
- RedshiftデータをAWSの分析・AI/MLサービス(例:Amazon SageMaker)と統合し、異常検知やデバイス挙動予測を実施。
- Redshiftの並列クエリ実行により、膨大なIoTデータセットに対して集計、結合、時系列分析を実行し、履歴およびほぼリアルタイムのインサイトを提供。
特長と利点
Redshiftとのデータ統合は以下のような特長とメリットをもたらします:
- 柔軟なイベント処理:EMQXルールエンジンを活用し、Redshiftはデバイスのライフサイクルイベント(接続、切断、状態変化)を低レイテンシで保存・処理可能です。RedshiftのMPPクエリエンジンと組み合わせることで、イベントデータを迅速に集計・分析し、障害検知や異常検知、長期利用傾向の把握が可能です。
- メッセージ変換:メッセージはEMQXルールを通じて高度な処理・変換が可能で、Redshiftに書き込まれるデータは分析に最適化された状態となります。この事前処理によりクエリの複雑さが軽減され、下流の利用効率が向上します。
- SQLテンプレートによる柔軟なデータ操作:EMQXのSQLテンプレートマッピングを使い、構造化されたIoTデータをRedshiftのテーブル・カラムに挿入可能です。RedshiftはPostgreSQL互換SQL、JSON用のSUPER型などの半構造化データ型、高度なインデックス機能をサポートし、クエリ最適化を実現します。カラムナストレージ、データ圧縮、ゾーンマップにより、大規模データセットのスキャン時間を大幅に短縮します。
- ビジネスプロセス統合:RedshiftはAWSエコシステムとシームレスに統合され、IoTデータをAmazon QuickSightなどのBIツール、AWS GlueやAWS Data Pipelineなどの分析サービス、Amazon SageMakerなどのAI/MLサービスに接続可能です。
- 高度な地理空間機能:RedshiftはGEOMETRYおよびGEOGRAPHY型を通じて地理空間データ型・関数をサポートし、ジオフェンシング、位置情報分析、ルート最適化が可能です。EMQXのリアルタイム取り込みと組み合わせることで、資産追跡、車両監視、位置情報に基づくイベントトリガーをほぼリアルタイムで実現できます。
- 組み込みのメトリクスと監視:EMQXは各Redshiftシンクのランタイムメトリクスを提供し、RedshiftはAmazon CloudWatchと連携してクラスター性能、クエリ実行メトリクス、ストレージ使用状況を監視可能です。これにより取り込みから分析までのエンドツーエンドの可観測性を確保します。
はじめる前に
このセクションでは、Redshift統合を作成する前に必要な準備について説明します。Redshiftクラスターの作成やデータベース・テーブルの準備方法を含みます。
前提条件
Amazon Redshiftでのデータベースとテーブルの作成
EMQXでRedshiftコネクターを設定する前に、Amazon Redshiftクラスター(またはServerlessワークグループ)が稼働していることと、IoTデータを格納するスキーマが準備されていることを確認してください。
Redshiftクラスターまたはワークグループをデプロイします。環境構築にはAmazon Redshiftクラスター作成ガイドを参照してください。
データベースユーザーの認証情報を設定します。初期クラスター作成時に、プライマリユーザー(多くは
adminuser)の管理者資格情報を指定します。あるいは、Redshift SQLを使いEMQX専用のデータベースユーザーを作成します。このユーザーは接続、テーブル作成、読み書き権限を持つ必要があります。例:
sqlCREATE USER emqx_user PASSWORD 'YourStrongPassword1';詳細はRedshift入門ガイドおよびユーザーガイドを参照してください。
後でEMQXのコネクター設定に使うため、ユーザー名(
emqx_user)とパスワードは控えておいてください。psql、SQL Workbench/J、DBeaverなどのPostgreSQL互換クライアントを使い、ホスト名、ポート、既存のデータベース名(例:デフォルトのdev)、ユーザー名、パスワードでRedshiftエンドポイントに接続します。接続後、EMQXからのIoTデータ受け入れ先となる
emqx_dataデータベースを作成します。sqlCREATE DATABASE emqx_data;emqx_dataデータベースに接続し、MQTTメッセージおよびクライアントイベントデータ保存用の2つのテーブルを作成します。クライアントID、トピック、ペイロード、作成日時を保存するデータテーブル
t_mqtt_msg作成用SQL:sqlCREATE TABLE t_mqtt_msg ( id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY, msgid VARCHAR(64), sender VARCHAR(64), topic VARCHAR(255), qos INTEGER, retain INTEGER, -- ペイロードがJSONの場合はSUPER型を検討、それ以外は大きめのVARCHARを使用 payload SUPER, arrived TIMESTAMPTZ );クライアントのオンライン/オフラインイベントをタイムスタンプ付きで保存する
emqx_client_eventsテーブル作成用SQL:sqlCREATE TABLE emqx_client_events ( id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY, clientid VARCHAR(255), event VARCHAR(255), created_at TIMESTAMPTZ DEFAULT CURRENT_TIMESTAMP );
Redshiftコネクターの作成
Redshiftシンクを追加する前に、EMQXでRedshiftコネクターを作成する必要があります。コネクターはEMQXがAmazon RedshiftクラスターまたはServerlessワークグループに接続する方法を定義します。
注意
Amazon Redshift Serverlessを使用している場合、コネクターが作成され接続が確立されると、データが書き込まれていなくても課金が発生する可能性があります。未使用のコネクターは削除するか、リソースを一時停止して予期せぬコストを回避してください。
EMQXダッシュボードで、Integration -> Connector に移動します。
ページ右上の Create をクリックします。
Create Connector ページで Redshift を選択し、Next をクリックします。
コネクター名を入力します。名前は英数字で始まり、英数字、ハイフン、アンダースコアを含めることができます。例:
my_redshiftRedshift接続情報を入力します:
- Server Host:Redshiftエンドポイントのホスト名(例:
redshift-cluster-1.abc123xyz.us-east-1.redshift.amazonaws.com)。AWS RedshiftコンソールのClustersまたはWorkgroupsページで確認可能です。 - Database Name:EMQXデータを格納する対象データベース。例:
emqx_data - Username:データ挿入権限を持つデータベースユーザー名。例:
emqx_user - Password:
emqx_userのパスワード - Enable TLS:Redshift接続でSSL/TLS暗号化が必要な場合はオンにします(クラウドサービス接続では推奨)。詳細は外部リソースアクセスのTLSを参照。
- Server Host:Redshiftエンドポイントのホスト名(例:
詳細設定(任意):接続プールサイズ、アイドルタイムアウト、リクエストタイムアウトなどの追加接続プロパティを設定可能です。詳細はシンクの機能を参照してください。
Test Connectivity をクリックし、EMQXが指定した設定でRedshiftクラスターに正常に接続できるか確認します。
Create をクリックしてコネクターを保存します。
作成後は以下のいずれかを選択できます:
- Back to Connector List をクリックして全コネクター一覧に戻る
- Create Rule をクリックして、このコネクターを使ったルールを即座に作成し、Redshiftへのデータ転送を設定する
詳細な例は以下を参照してください:
メッセージ保存用Redshiftシンクを使ったルール作成
このセクションでは、ダッシュボードでソースMQTTトピックt/#からのメッセージを処理し、処理済みデータを設定済みRedshiftシンク経由でt_mqtt_msgテーブルに保存するルールの作成方法を示します。
ダッシュボードの Integration -> Rules ページに移動します。
ページ右上の Create をクリックします。
ルールIDに
my_ruleを入力し、SQLエディターにルールを記述します。ここではt/#トピックのMQTTメッセージをRedshiftに保存する例です。ルールのSELECT句で選択したフィールドは、SQLテンプレート内で使用する変数をすべて含む必要があります。ルールSQLは以下の通りです:sqlSELECT * FROM "t/#"TIP
初心者の方は SQL Examples をクリックし、Enable Test を有効にしてSQLルールの学習とテストが可能です。
- Add Action ボタンをクリックし、ルール発動時に実行するアクションを定義します。このアクションにより、EMQXはルールで処理したデータをRedshiftに送信します。
Type of Action のドロップダウンからRedshiftを選択し、Action ドロップダウンはデフォルトの
Create Actionのままにするか、既存のRedshiftアクションを選択可能です。本例では新規シンクを作成しルールに追加します。シンクの名前と説明をフォームに入力します。
Connector ドロップダウンから先に作成した
my_redshiftを選択します。新規コネクターはドロップダウン横のボタンから作成可能です。設定パラメーターはRedshiftコネクターの作成を参照してください。SQL Template を設定します。以下のSQL文を使ってデータを挿入します。
注意:これはプリプロセス済みSQLのため、フィールドは引用符で囲まず、文末にセミコロンを書かないでください。
sqlINSERT INTO t_mqtt_msg ( msgid, topic, qos, payload, arrived ) VALUES ( ${id}, ${topic}, ${qos}, ${payload}, timestamp 'epoch' + (${timestamp} :: bigint / 1000) * interval '1 second' )フォールバックアクション(任意):メッセージ配信失敗時の信頼性向上のため、1つ以上のフォールバックアクションを定義できます。詳細はフォールバックアクションを参照してください。
詳細設定(任意):詳細はシンクの機能を参照してください。
Create をクリックする前に、Test Connectivity をクリックしてシンクがRedshiftサーバーに接続可能かテストできます。
Create ボタンをクリックし、シンク設定を完了します。新しいシンクがAction Outputsに追加されます。
Create Rule ページで設定内容を確認し、Save をクリックしてルールを生成します。
ルール作成が成功すると、Integration -> Rules ページで新規ルールを確認でき、Action (Sink) タブで新規Redshiftシンクも確認できます。
また、Integration -> Flow Designer を開くとトポロジーが可視化され、t/#トピックのメッセージがルールmy_ruleで解析されRedshiftに書き込まれている様子を確認できます。
イベント記録用Redshiftシンクを使ったルール作成
このセクションでは、クライアントのオンライン/オフライン状態を記録し、イベントデータを設定済みRedshiftシンク経由でemqx_client_eventsテーブルに保存するルールの作成方法を示します。
手順はメッセージ保存用のRedshiftシンクを使ったルール作成とほぼ同様で、SQLテンプレートとSQLルールのみ異なります。
オンライン/オフライン状態記録用のSQLルール文は以下の通りです:
SELECT
  *
FROM
  "$events/client_connected", "$events/client_disconnected"
イベント記録用のSQLテンプレートは以下の通りです:
注意:これはプリプロセス済みSQLのため、フィールドは引用符で囲まず、文末にセミコロンを書かないでください。
INSERT INTO emqx_client_events(clientid, event, created_at) VALUES (
  ${clientid},
  ${event},
  TO_TIMESTAMP((${timestamp} :: bigint)/1000)
)
ルールのテスト
MQTTXを使い、トピックt/1にメッセージを送信してオンライン/オフラインイベントをトリガーします。
mqttx pub -i emqx_c -t t/1 -m '{ "msg": "hello Redshift" }'2つのシンクの稼働状況を確認します。メッセージ保存用シンクは新規の受信メッセージ1件と送信メッセージ1件があるはずです。イベント記録用シンクは2件のイベントレコードがあります。
t_mqtt_msgデータテーブルにデータが書き込まれているか確認します。
emqx_data=# select * from t_mqtt_msg;
 id |              msgid               | sender | topic | qos | retain |            payload
        |       arrived
----+----------------------------------+--------+-------+-----+--------+-------------------------------+---------------------
  1 | 0005F298A0F0AEE2F443000012DC0002 | emqx_c | t/1   |   0 |        | { "msg": "hello Redshift" } | 2023-01-19 07:10:32
(1 row)emqx_client_eventsテーブルにデータが書き込まれているか確認します。
emqx_data=# select * from emqx_client_events;
 id | clientid |        event        |     created_at
----+----------+---------------------+---------------------
  3 | emqx_c   | client.connected    | 2023-01-19 07:10:32
  4 | emqx_c   | client.disconnected | 2023-01-19 07:10:32
(2 rows)