EMQX AI
大規模言語モデル(LLM)の急速な進展により、AIはかつてない速度で産業を変革し、IoTも根本的な変貌を遂げています。従来のスマートハードウェアは固定機能を中心に構築され、主に受動的な実行者として動作していました。現在、デバイスは知覚、理解、対話、行動の統合能力を備えたインテリジェントエージェントへと進化し、自律性とコンテキスト認識に基づく意思決定を可能にしています。この進化は多くの応用分野で破壊的なアップグレードを促進しています。
感情的な伴侶としては、単純な電子玩具が感情認識、コンテキスト理解、共感的対話を可能にするインテリジェントパートナーへと変わりつつあります。スマートホームでは、孤立したデバイスが自然言語で制御される統合された全館エコシステムに置き換えられています。ロボティクス分野では、サービスロボットや産業用ロボットからヒューマノイドロボットに至るまで、リアルタイムの知覚、意図理解、即時応答が求められる具現化されたインテリジェントシステムが必要とされています。自動車分野では、インテリジェント車両が移動するインテリジェント空間として台頭し、車載AIアシスタントが複雑な交通状況を管理し、継続的かつ自然な音声対話を通じて運転体験を向上させています。
AIハードウェアの核:リアルタイムで正確かつコンテキスト豊かな知覚とマルチモーダルインタラクション
大規模モデルは強力な推論と生成能力を持ちますが、その性能は根本的に与えられるコンテキストの質に依存します。システムが現在の状況、環境変化、ユーザーの真の意図を正確に理解できなければ、モデルは幻覚を起こしたり、無関係な応答を生成したりします。人間も同様で、情報が限られれば誤った判断を下し、完全なコンテキストがあれば正確な意思決定が可能です。インテリジェントハードウェアにおいては、AIが現実世界を理解することが、対話の安定性と信頼性を向上させるために不可欠です。信頼できるAIエージェントは、以下の3つのコア能力を備えている必要があります。
マルチソースデータ:AIに現実世界を理解させる
多様なソースからのデータが集まってAIのワールドモデルを形成します。
- 環境データ:温度、湿度、明るさ、重力などの物理的信号がリアルタイムの状態認識を提供します。
- クラウドベースの知識:地図、天気、交通状況、充電ステーションの空き状況などのサービスがデバイスのグローバルな認識を拡張します。
- サードパーティのコンテキスト:コンテンツサービスや知識ベースにより、より複雑な質問やユーザーニーズに対応可能です。
データソースが豊富であればあるほど、システムは今何が起きているか、ユーザーが本当に何を必要としているかをより正確に把握できます。
リアルタイムイベント認識:ミリ秒単位の変化理解
イベントはコンテキスト理解のアンカーであり、LLMやVLMを駆動する重要なトリガーです。
- 環境変化:例えば、部屋の明るさが突然変わる場合。
- 状態変化:例えば、玩具が予期せず倒れた場合。
- 特殊シナリオ:例えば、車がロックされた後の後部座席圧力センサーの異常検知など。
ミリ秒レベルのレイテンシでイベントを捉える能力が、システムの応答速度と正確性を直接決定します。
マルチメディアインタラクション:自然な人機コミュニケーションを実現
マルチメディアインタラクションは、従来の「音声アシスタント」から真に没入型のインテリジェント体験への飛躍を意味します。
- 音声:感情表現、自然なプロソディ、多言語対応。
- 映像:表情認識、シーン理解、リアルタイムの視覚フィードバック。
- 制御機能:音声と映像理解を組み合わせ、よりインテリジェントでコンテキスト認識されたシナリオを実現。
インテリジェントハードウェア構築のための6つの必須要素
入出力の両面から、適格なインテリジェントハードウェアを構築するために必要な6つの要素を定義します。
入力機能
- 知覚:エージェントは様々なセンサーを通じて物理世界を知覚します。環境条件の温度センサー、位置認識のための測位システム、動作や姿勢検出のための加速度計などです。
- 聴覚:マイクロフォンは周囲の音やユーザーの発話を捉えます。ノイズ抑制やエコーキャンセレーション、多言語音声認識と組み合わせることで、デバイスは自然な人間の言語を「聴く」ことが可能です。
- 視覚:カメラは画像認識、物体検出、顔認識、ジェスチャー認識を可能にする視覚情報を収集し、デバイスが周囲やユーザーの行動を「見る」ことを可能にします。
出力機能
- 理解:LLMとVLMモデルを統合することで、デバイスは意味理解、感情認識、コンテキスト記憶を実現し、正確な意図把握と一貫した多ターン対話を可能にします。
- 音声:高品質スピーカーは複数の声質、感情表現、コンテキストに応じたイントネーションで合成音声を出力し、自然で流暢なユーザーとのコミュニケーションを実現します。
- 行動:MCPプロトコルを通じて、デバイスは音量調整、カメラ起動、複数デバイスの連携などの機能を制御し、ユーザーの指示に応じた具体的な行動を実行します。
EMQXとRTCサービスを中心としたインテリジェントIoTアーキテクチャ
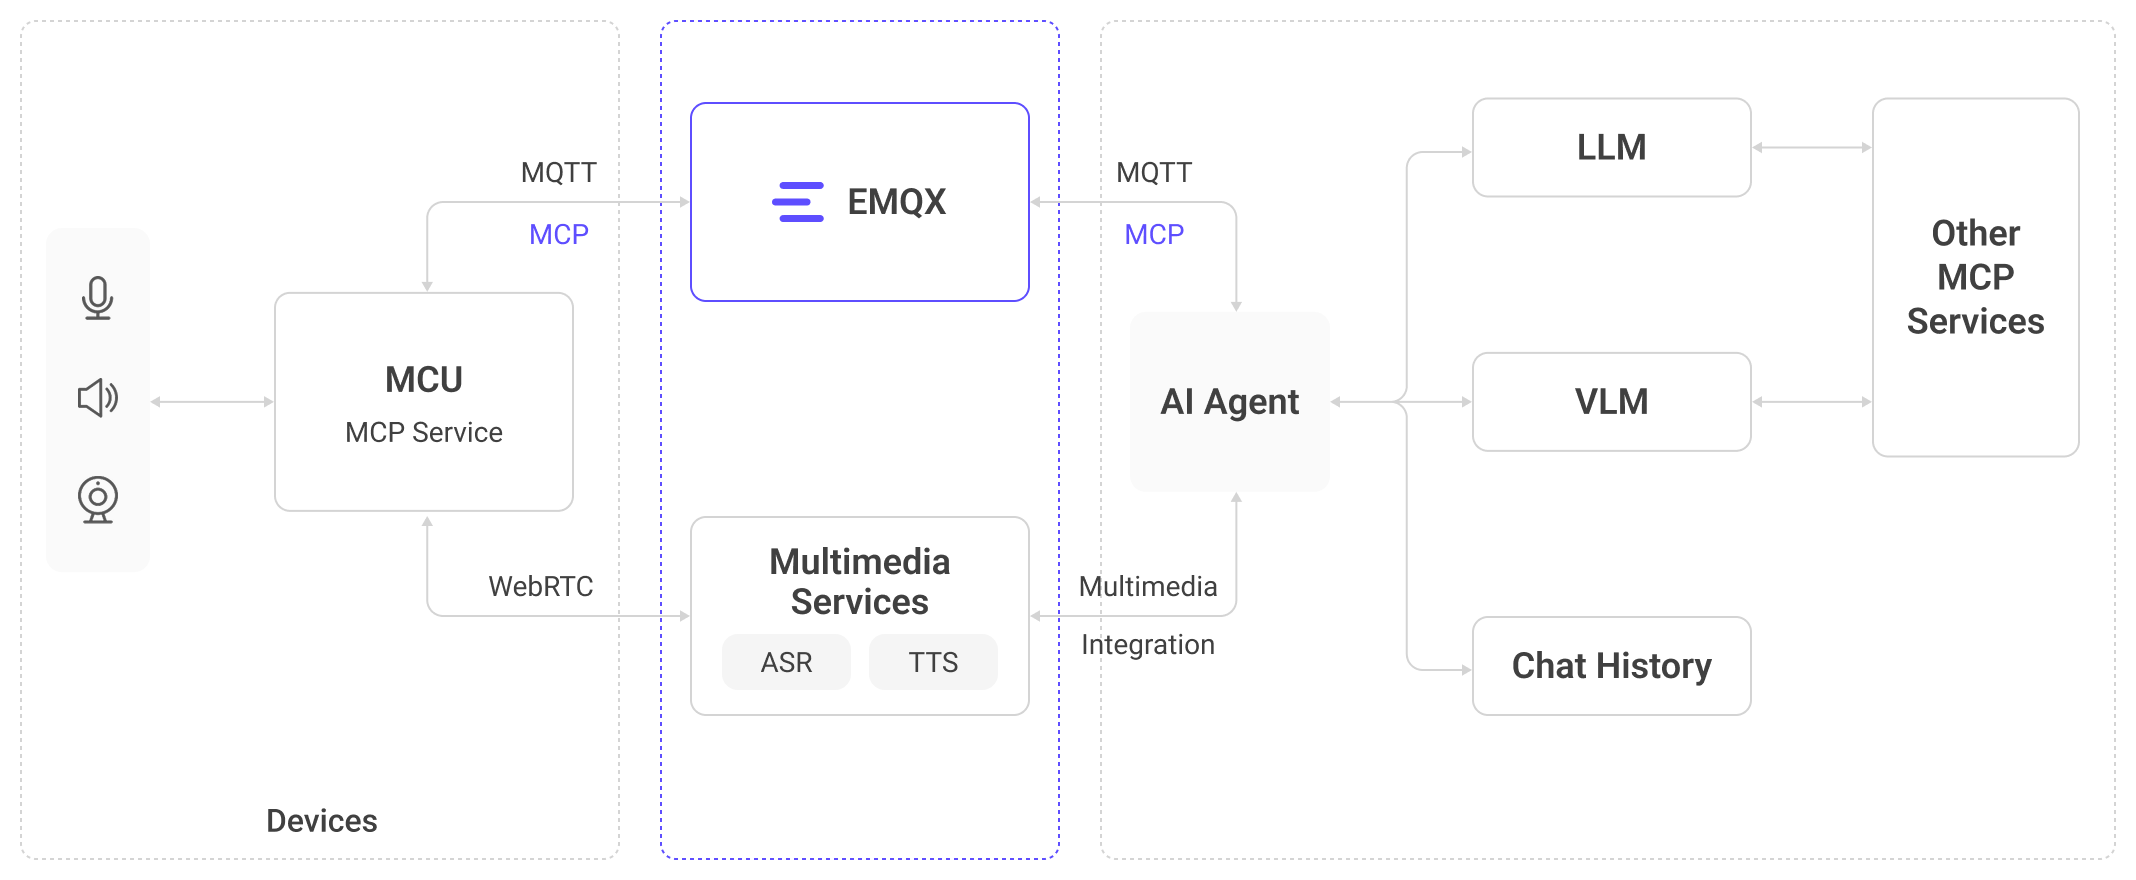
EMQXのエンドツーエンドソリューションは、デバイス層、通信層、処理層、アプリケーション層を統合した階層型アーキテクチャを採用しています。センサーからのデータ収集とエッジ処理、リアルタイム通信(MQTT + WebRTC)、クラウド上の大規模モデルまでを一貫した**「知覚」→「理解」→「行動」**の閉ループチェーンとして構築しています。このアーキテクチャは、軽量デバイスからロボティクスや車載システムのような複雑なシナリオまで対応可能です。
知覚:AIワールドモデルのリアルタイムコンテキストを提供するEMQX
知覚はすべてのインテリジェントな行動の基盤です。人間の場合、入力の大部分は視覚、聴覚、触覚から得られ、音声は日常活動の6〜10%に過ぎません。同様に、リアルタイムの世界知覚を持たないAIエージェントは、物理世界で動作する実体ではなく単なるアルゴリズムに過ぎません。
EMQXはデバイス向けに包括的なリアルタイムコンテキスト基盤を提供します。
- ミリ秒レベルのデータパイプライン:デバイスからクラウドへのエンドツーエンドのメッセージ転送がミリ秒単位のレイテンシで実現され、即時のイベント処理を保証します。
- フルスペクトラムSDK:低消費電力MCUからLinuxベースのデバイスまで統一的にアクセスでき、センサー統合を簡素化します。
- 大規模デバイス管理:大規模な同時接続、メッセージ処理、状態追跡をサポートし、玩具から自動車システムまで幅広いシナリオに対応します。
詳細はこちら
聴覚・視覚・発話:音声・映像ストリームのアクセスと処理
WebRTCはリアルタイムの音声・映像インタラクションの中核技術です。低レイテンシかつ高い互換性により、インテリジェントハードウェアのマルチメディアインタラクションに最適なソリューションとなっています。
- 音声入力:デバイスがユーザーを真に「理解」することを可能にします。高品質マイクとノイズ抑制、エコーキャンセレーションにより複雑な環境でも音声の明瞭さを維持します。リアルタイムASRは多言語対応で音声をテキストに変換し、意味理解の基盤を形成します。
- 映像入力:デバイスに「目」を提供します。高解像度カメラと物体認識、顔認識、動作理解を組み合わせ、ユーザーの状態や行動を知覚します。ジェスチャー操作により非接触でより自然な操作が可能です。
- 音声出力:コミュニケーションをより自然にします。最新のTTSは複数の声質と感情合成をサポートし、コンテキストに応じて自動的にトーンやリズムを調整し、機械の応答をより人間らしく魅力的にします。
詳細はこちら
Volcano Engine RTCによる音声・映像アクセス構築
理解:LLMとVLMの統合
LLMは言語の理解と生成を担い、VLMは視覚と言語を統合します。これにより、デバイスは単に「聴き」「見」るだけでなく、真に理解することが可能になります。従来のルールベースエンジンと比べて、最新の大規模モデルは強力な推論、記憶、一般化能力を備え、極めて複雑でオープンエンドな対話シナリオに適しています。
詳細:
行動:MCPデバイス制御 — AIとデバイスをつなぐ架け橋
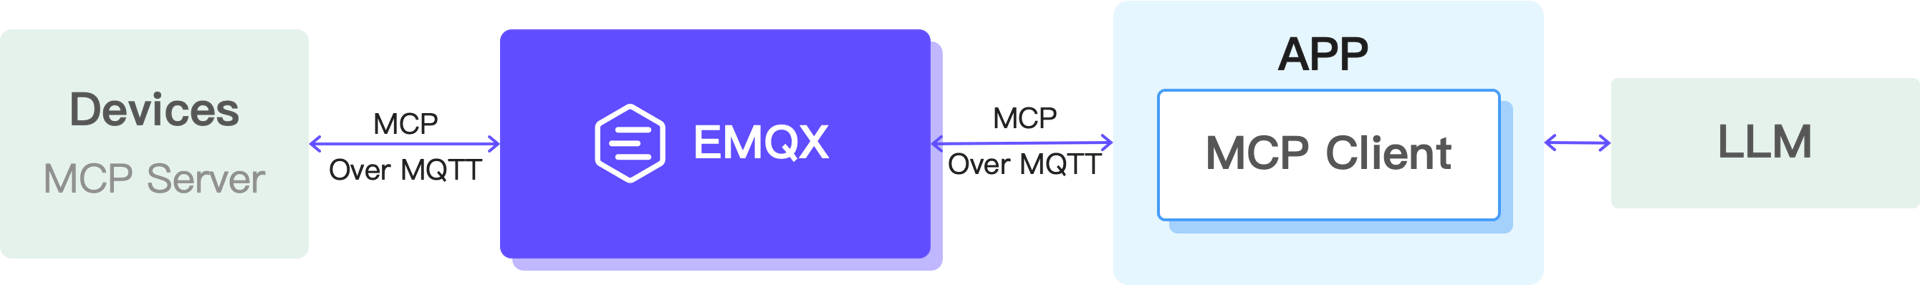
Model Context Protocol(MCP)は、AIが自然で標準化され動的な方法でデバイスの機能を呼び出すことを可能にします。
- MCPサーバー:デバイス側に展開され、カメラ制御、音量調整、機械的動作コマンドなどのデバイス機能を登録します。
- MCPクライアント:クラウドまたはエッジで動作し、AIの意思決定を実行可能なデバイス制御コマンドに変換します。
- MCPホスト:AIアプリケーションに組み込まれ、ユーザーの意図をツール呼び出しに変換し、デバイスとの双方向連携を実現します。
MCPにより、AIは行動力を得て、デバイスは統一された制御インターフェースを持つことで、複数デバイスの連携や複雑なシナリオ制御が可能になります。
詳細はこちら
連携:A2A over MQTT — エージェント間コラボレーション
インテリジェントハードウェアやAIエージェントが増える中、個々のエージェントは他のエージェントにタスクを委譲し協調する必要が高まっています。Agent-to-Agent(A2A)プロトコルは、エージェント同士の発見、タスク要求の交換、結果のストリーミングを定義し、単一のエージェントでは対応困難な複雑なワークフローを多エージェントシステムとして処理可能にします。
EMQXは内蔵のA2Aレジストリを通じて、エージェントが公開するAgent Cardを記録し、接続状態を追跡し、標準MQTTトピックを用いてタスク要求をルーティングする形でA2A over MQTTを実装しています。
詳細はこちら
典型的なインテリジェントエージェントの対話シナリオ
- 純音声対話:音声のみを入力とし、WebRTC単独でリアルタイムかつ高品質な対話が可能です。
- 音声/映像によるデバイス制御:マイクやカメラを介してデバイスを操作し、安定した制御パイプラインのためにWebRTCとMQTTの両方が必要です。
- 知覚駆動の制御とマルチメディアインタラクション:センサーでイベントを検知し、AIが判断し、音声や映像で応答する没入型のインテリジェント体験を実現します。前述のシナリオ同様、WebRTCとMQTTの統合が求められます。