EMQXクラスタリングの設計
MQTTはステートフルなプロトコルであり、ブローカーは各MQTTセッションの状態情報(サブスクライブされたトピックや未完了のメッセージ送信など)を保持する必要があります。MQTTブローカーのクラスタリングにおける主な課題の一つは、これらの状態をすべてのクラスタノード間で効率的かつ信頼性高く同期・複製することです。
EMQXは高いスケーラビリティとフォールトトレランスを備えたMQTTブローカーであり、複数ノードによるクラスタモードで動作可能です。EMQXのクラスタリングは、IoTメッセージングシステムのスケーラビリティ、可用性、信頼性、管理性を向上させるため、大規模またはミッションクリティカルなアプリケーションに推奨される手法です。本ページでは、MQTTブローカーのクラスタリングの必要性とEMQXがどのようにこれを実現し、単一クラスタ内で数百万のユニークなワイルドカードサブスクライバーをサポートできるかを解説します。
EMQXクラスタの作成および運用に関する詳細な手順は、EMQXクラスタをご参照ください。
クラスタリングの主要な側面
クラスタ設計において考慮すべき重要な側面がいくつかあります。これらはクラスタの成功を左右する最も重要な要素であることが多いです。概要は以下の通りです。
集中管理:クラスタ内のすべてのノードは単一の管理コンソールから監視・制御可能であり、集中管理ができること。
データ整合性:クラスタ内のすべてのノードがルーティング情報の一貫したビューを持つこと。これはクラスタ内の全ノード間でデータを複製することで実現されます。
容易なスケールアウト:クラスタ管理の複雑さを減らすため、ノードの追加は複雑であってはならず、新規ノードを自動検出しクラスタに追加できること。
クラスタのリバランス:最小限の運用オーバーヘッドで、各ノードの負荷アンバランスを検知し、負荷の少ないノードへワークロードを再割り当てできること。これにより、1台または複数ノードの障害時もクラスタが継続稼働可能となります。
大規模クラスタ対応:システムの増大する要求に対応するため、ノードを追加してクラスタを水平スケールできること。
自動フェイルオーバー:ノード障害時にクラスタが自動的に検知し、残りのノードへワークロードを再割り当てできること。
ネットワークパーティション耐性:ネットワークパーティションが発生してもクラスタが継続稼働できること。
EMQXはこれらの目標を最も効率的に達成するために多様な手法を用いています。以下のセクションでクラスタリングの主要な側面を詳述します。
データ複製チャネル
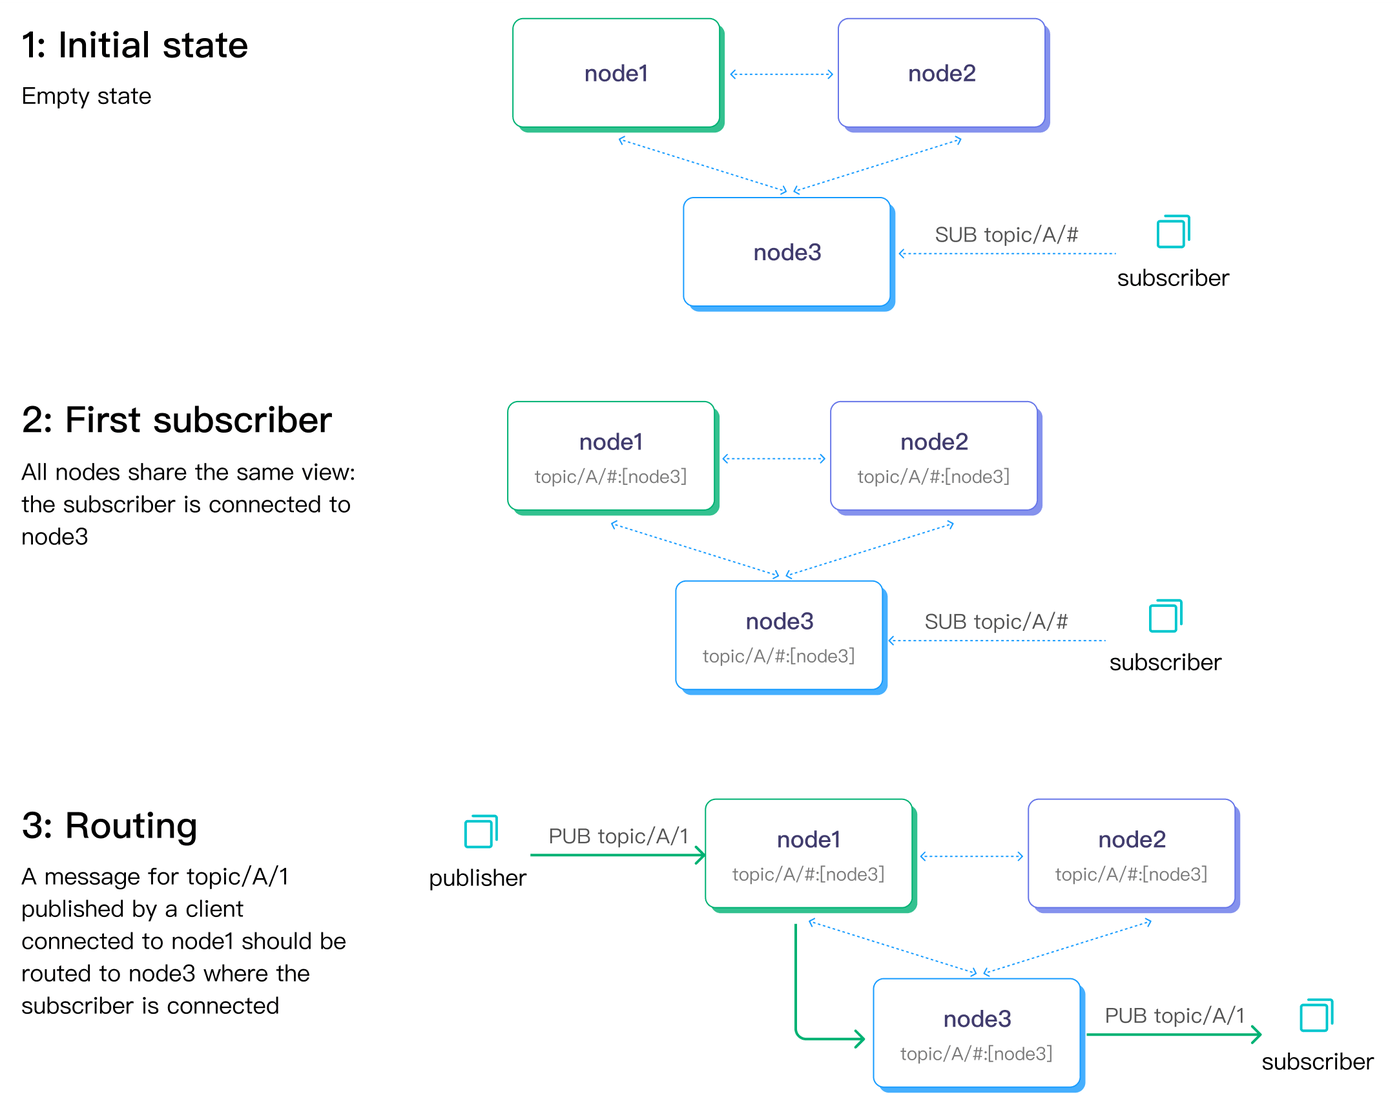
メタデータおよびメッセージの複製を実現するために、Erlang分散プロトコルとカスタム分散プロトコルがブローカー間のリモートプロシージャコールに利用されます。EMQXクラスタには2つのデータ複製チャネルがあります。
メタデータ複製:どのノードがどの(ワイルドカード)トピックをサブスクライブしているかなどのルーティング情報。これは「Erlang分散」プロトコルによって実現され、各ノードはクライアント兼サーバとして機能します。このプロトコルのデフォルトリッスンポートは4370番です。
メッセージ配信:ノード間でメッセージを転送する際のチャネル。メッセージ配信チャネルはコネクションプールを用い、各ノードはデフォルトで5370番ポート(Dockerコンテナ内では5369番)をリッスンします。Erlang分散プロトコルとは異なり、こちらは単一接続ではありません。
下図は2つのデータ複製チャネルとパブリッシュ・サブスクライブのフローを示しています。ノード間の破線はメタデータ複製を、実線矢印はメッセージ配信チャネルを表しています。
組み込みデータベース
EMQXは内部データを2種類の組み込みデータベース管理システムのいずれかに格納します。
Mria:軽量なインメモリデータベースで、ルーティングテーブルやランタイム設定など読み込みが多いワークロードに使用されます。CAP定理においては可用性を重視した設計です。
Durable Storage (DS):ディスクベースのストリーミングデータベースで、耐久セッションやメッセージキューなど書き込みが多く大量のデータに対応します。整合性を重視した設計です。
これら2つのデータベース管理システムは特性が大きく異なり、ネットワークパーティション時の保証も異なります。本ドキュメントでは主にMriaとEMQXの動作に焦点を当て、耐久性機能の詳細には踏み込みません。耐久ストレージに関する情報はDurable Storageをご参照ください。
Mriaテーブルはさらに以下の2種類に分類されます。
Regular:テーブル内容がグローバルに一様であるもの。Mriaテーブルの大部分はこちらです。
Merge:各レコードが特定のEMQXノードに帰属し、そのノードのみが書き込み可能。他ノードからは読み取り専用として見えます。
ノードの役割:CoreとReplicant
Mriaはcoreとreplicantという2種類のノード役割を持つ混合ネットワークトポロジーを採用しています。
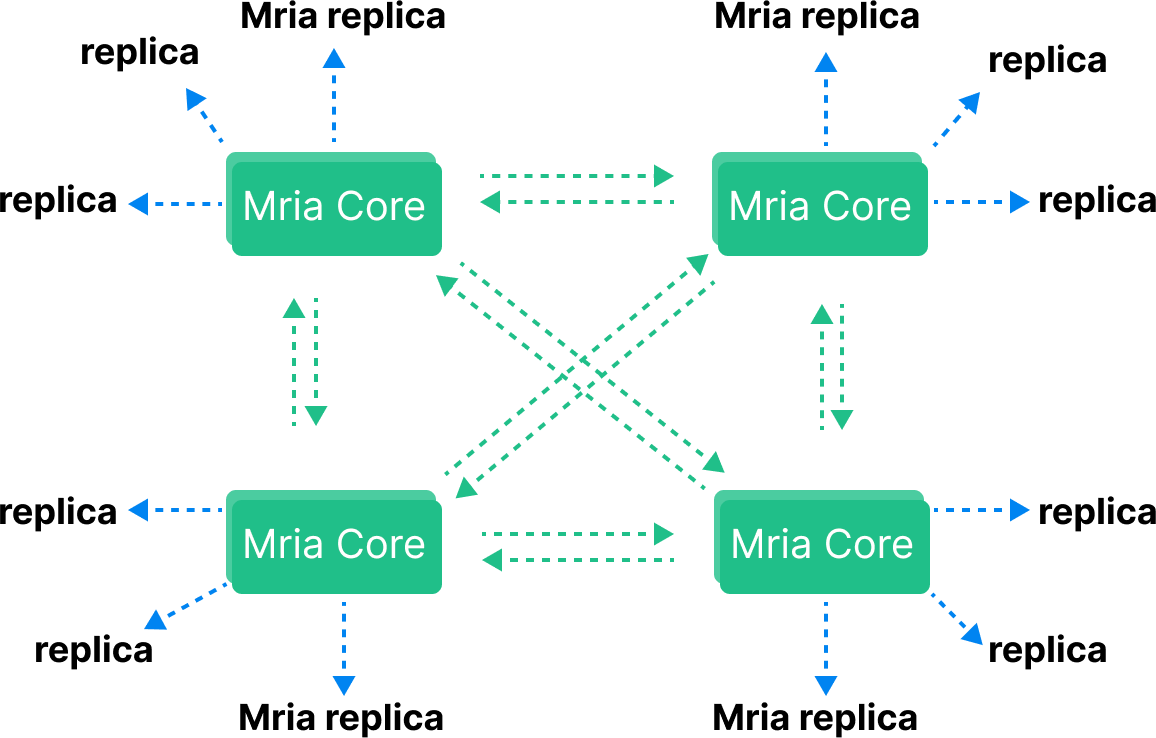
EMQXクラスタには最低1台のCoreノードと任意数のReplicantノードが必要です。
CoreノードはMriaの中核であり、regularテーブルの更新を調整します。これらのテーブルへの更新はCoreノードクラスタ間で同期的に複製されます。この調整にはコストがかかるため、データ冗長性要件を満たす最小限のCoreノード数に抑え、残りのノードにはReplicant役割を割り当てることが推奨されます。典型的なCoreノード数は3台です。
Replicantノードはトランザクション処理に直接関与せず、Coreノードに接続してデータ更新を受動的に複製します。Replicantは書き込み操作を行えず、書き込み要求はCoreノードに転送されます。また、ReplicantはCoreノードからのデータを完全にローカルに保持するため、読み込み操作の効率が高く、EMQXの各種データベースクエリのレイテンシ低減に寄与します。
Replicantノードは書き込みに参加しないため、Replicantノード数が増えても書き込みのレイテンシは影響を受けません。これにより、数十台のReplicantノードを持つ大規模クラスタの構築が可能です。
パフォーマンス向上のため、データ複製は独立したデータストリームに分割されます。複数の関連テーブルは同じRLOG Shard(複製ログシャード)に割り当てられ、トランザクションはCoreノードからReplicantノードへ順次複製されます。異なるRLOG Shardは独立しています。
Mergeテーブル
MergeテーブルはMriaの特殊なテーブルで、各レコードが特定のEMQXノードに明確に紐づきます。代表例はEMQXのルーティングテーブルです。ルーティングテーブルはMQTTブローカーで最も重要な分散データ構造であり、すべてのトピックのルーティング情報を格納します。パブリッシュされたメッセージをどのノードに配信するかを決定するために使用されます。
通常のテーブルとは異なり、すべてのEMQXノード(Core・Replicant問わず)は自ノードのレコードを直接更新し、他ノードとの調整は行いません。更新は非同期にクラスタ全体へ複製されます。各ノードはMergeテーブルにおいてCoreとReplicantの両方の役割を兼ねています。
この設計の利点は以下の通りです。
- 書き込みレイテンシの低減
- Coreノードへの負荷軽減
- パーティション耐性の向上:完全に分断されたネットワークでも各ノードは少なくとも自ノードのルートを保持
ネットワークパーティションが回復すると、ノードはルーティングテーブルの内容をマージします。これが名称の由来です。
集中管理
EMQXはクラスタ内のすべてのノードを単一の管理コンソールから監視・制御できるため、集中管理が可能です。これにより大量のデバイスやメッセージの管理が容易になります。コンソールはWebブラウザからアクセス可能で、ユーザーフレンドリーなインターフェースを提供します。任意のcoreタイプノードが管理用HTTP APIエンドポイントとして機能します。
オンライン設定管理機能により、ノードの再起動なしにクラスタ内全ノードの設定変更が可能です。これはノードの追加・削除などクラスタ設定の更新に特に有用です。
容易なスケールアウト
EMQXは水平スケールを容易に設計されています。CLI、API、またはダッシュボードからいつでもノードの追加・削除が可能です。
例えば、新規ノードをクラスタに追加するには以下のようなコマンドを実行するだけです。
emqx ctl cluster join emqx@node1.my.netここでemqx@node1.my.netはクラスタ内の既存ノードの一つです。
またダッシュボードからボタン操作で新規ノードをクラスタに招待できます。
豊富な管理インターフェースにより、クラスタ管理をスクリプト化しDevOpsパイプラインに組み込むことも容易です。
EMQX v5ではreplicaノードはステートレス設計のため、オートスケーリンググループに配置してより良いDevOps運用が可能です。
クラスタのリバランス
新規ノードがクラスタに参加すると、初期状態は空の状態です。優れたロードバランサーがあれば、新規接続クライアントは新ノードに接続しやすくなりますが、既存クライアントは依然として旧ノードに接続したままです。
クライアントが短期間に再接続すればクラスタは迅速にバランスしますが、再接続がない場合は長期間アンバランスな状態が続きます。
この問題に対処するため、EMQX(バージョン4.4以降)は「クラスタロードリバランシング」機能を導入しました。この機能により、クラスタは過負荷ノードから負荷の低いノードへセッションを移行し、自動的に負荷をリバランスできます。
「リバランス」の極端な例が「避難(evacuation)」であり、特定ノードの全セッションを他ノードに移行します。これはノードをクラスタから除去したい場合に有用です。
クラスタサイズ
数百万の同時接続規模では、単一マシンでの処理は不可能なため水平スケールが必須です。
EMQX v5のcore-replicaクラスタリングアーキテクチャにより、はるかに大規模なクラスタを構築可能です。
ベンチマークでは、23ノードクラスタで5,000万のパブリッシャーと5,000万のワイルドカードサブスクライバーを処理しました。詳細はブログ記事をご覧ください。
なぜワイルドカードかというと、ワイルドカードサブスクリプションはMQTTブローカークラスタのスケーラビリティを評価するゴールドスタンダードであり、基盤となるデータ構造とアルゴリズムに最大の負荷をかけるためです。
自動フェイルオーバー
MQTTプロトコル仕様にはセッションアフィニティの概念がありません。つまりクライアントはクラスタ内の任意のノードに接続しても、サブスクライブしたトピックのメッセージを受信可能です。またMQTTにはサービスディスカバリ機構もなく、クライアントはクラスタノードのアドレスを知っている必要があります。通常はクラスタ内の全ノードリスト、あるいは適切なノードにルーティングするロードバランサーをクライアントに設定します。
EMQXはクラスタ前段にロードバランサーを置く設計です。ヘルスチェックエンドポイントにより、ロードバランサーはクラスタノードの健全性を検知し、クライアントを適切なノードにルーティングします。
Erlangのノード監視機構を用いて、EMQXノードは互いの健全性を監視し、不健康なノードを自動的にクラスタから除外します。
ネットワークパーティション耐性
ネットワークパーティションが発生すると、クラスタは複数の孤立したサブクラスタに分割され、それぞれが唯一のアクティブクラスタと誤認する「スプリットブレイン」問題が起こります。本番クラスタはネットワークパーティションから自動復旧可能でなければなりません。
EMQXの「autoheal」機能はネットワークパーティション後のクラスタを自動的に修復します。有効化されている場合、パーティション発生後の回復時にクラスタ内ノードは以下の手順で修復を行います。
回復処理はCoreノードとReplicantノードで異なります。
Coreノードの回復
- ノードは最長アップタイムのリーダーノードにパーティション情報を報告します。
- リーダーノードはグローバルなネットスプリットビューを作成し、多数派に属するCoreノードの一つをコーディネーターに選出します。
- リーダーノードはコーディネーターに少数派のCoreノードに再起動を指示させます。
- 少数派CoreノードはMriaテーブルの内容を多数派パーティションの内容で置き換えます。
Replicantノードの回復
Replicantノードはネットワークパーティション修復時に再起動されません。これによりクライアント接続を維持します。
代わりに以下の処理を行います。
- 少数派パーティションのReplicantはregular Mriaテーブルのレプリカを再初期化します。
- ルーティングテーブルの内容をマージし、多数派と少数派のノード間でルートを再確立します。
- クライアントはグローバルセッションレジストリへの存在を再確立します。
パーティション回復時に生成されるログメッセージやアラームについてはMrIaログとアラームをご参照ください。
まとめ
本記事ではEMQXの新しいクラスタリングアーキテクチャを紹介しました。また、スケーラビリティ、自動フェイルオーバー、ネットワークパーティション耐性など、本番環境に適したMQTTブローカークラスタの主要な側面と、それらを実現するEMQXの仕組みについて解説しました。