Amazon S3へのMQTTデータ取り込み
Amazon S3 は、高い信頼性、安定性、セキュリティを備えたインターネットベースのストレージサービスであり、迅速なデプロイと使いやすさが特徴です。EMQXはMQTTメッセージを効率的にAmazon S3バケットに保存でき、柔軟なIoTデータストレージ機能を実現します。
本ページでは、EMQXとAmazon S3間のデータ統合について詳しく紹介し、ルールおよびSinkの作成方法を実践的に解説します。
TIP
EMQXは以下のようなS3プロトコル対応の他のストレージサービスとも互換性があります:
- MinIO:MinIOは高性能で分散型のオブジェクトストレージシステムです。Amazon S3 API互換のオープンソースオブジェクトストレージサーバーで、プライベートクラウド構築に適しています。
- Google Cloud Storage:Google Cloud StorageはGoogle Cloudの統合オブジェクトストレージで、開発者や企業が大量のデータを保存可能です。Amazon S3互換のインターフェースを提供します。
ビジネスニーズやシナリオに応じて適切なストレージサービスを選択できます。
動作概要
EMQXのAmazon S3データ統合はすぐに使える機能で、複雑なビジネス開発にも簡単に設定可能です。典型的なIoTアプリケーションでは、EMQXがデバイス接続とメッセージ転送を担うIoTプラットフォームとして機能し、Amazon S3がメッセージデータの保存プラットフォームとして役割を果たします。
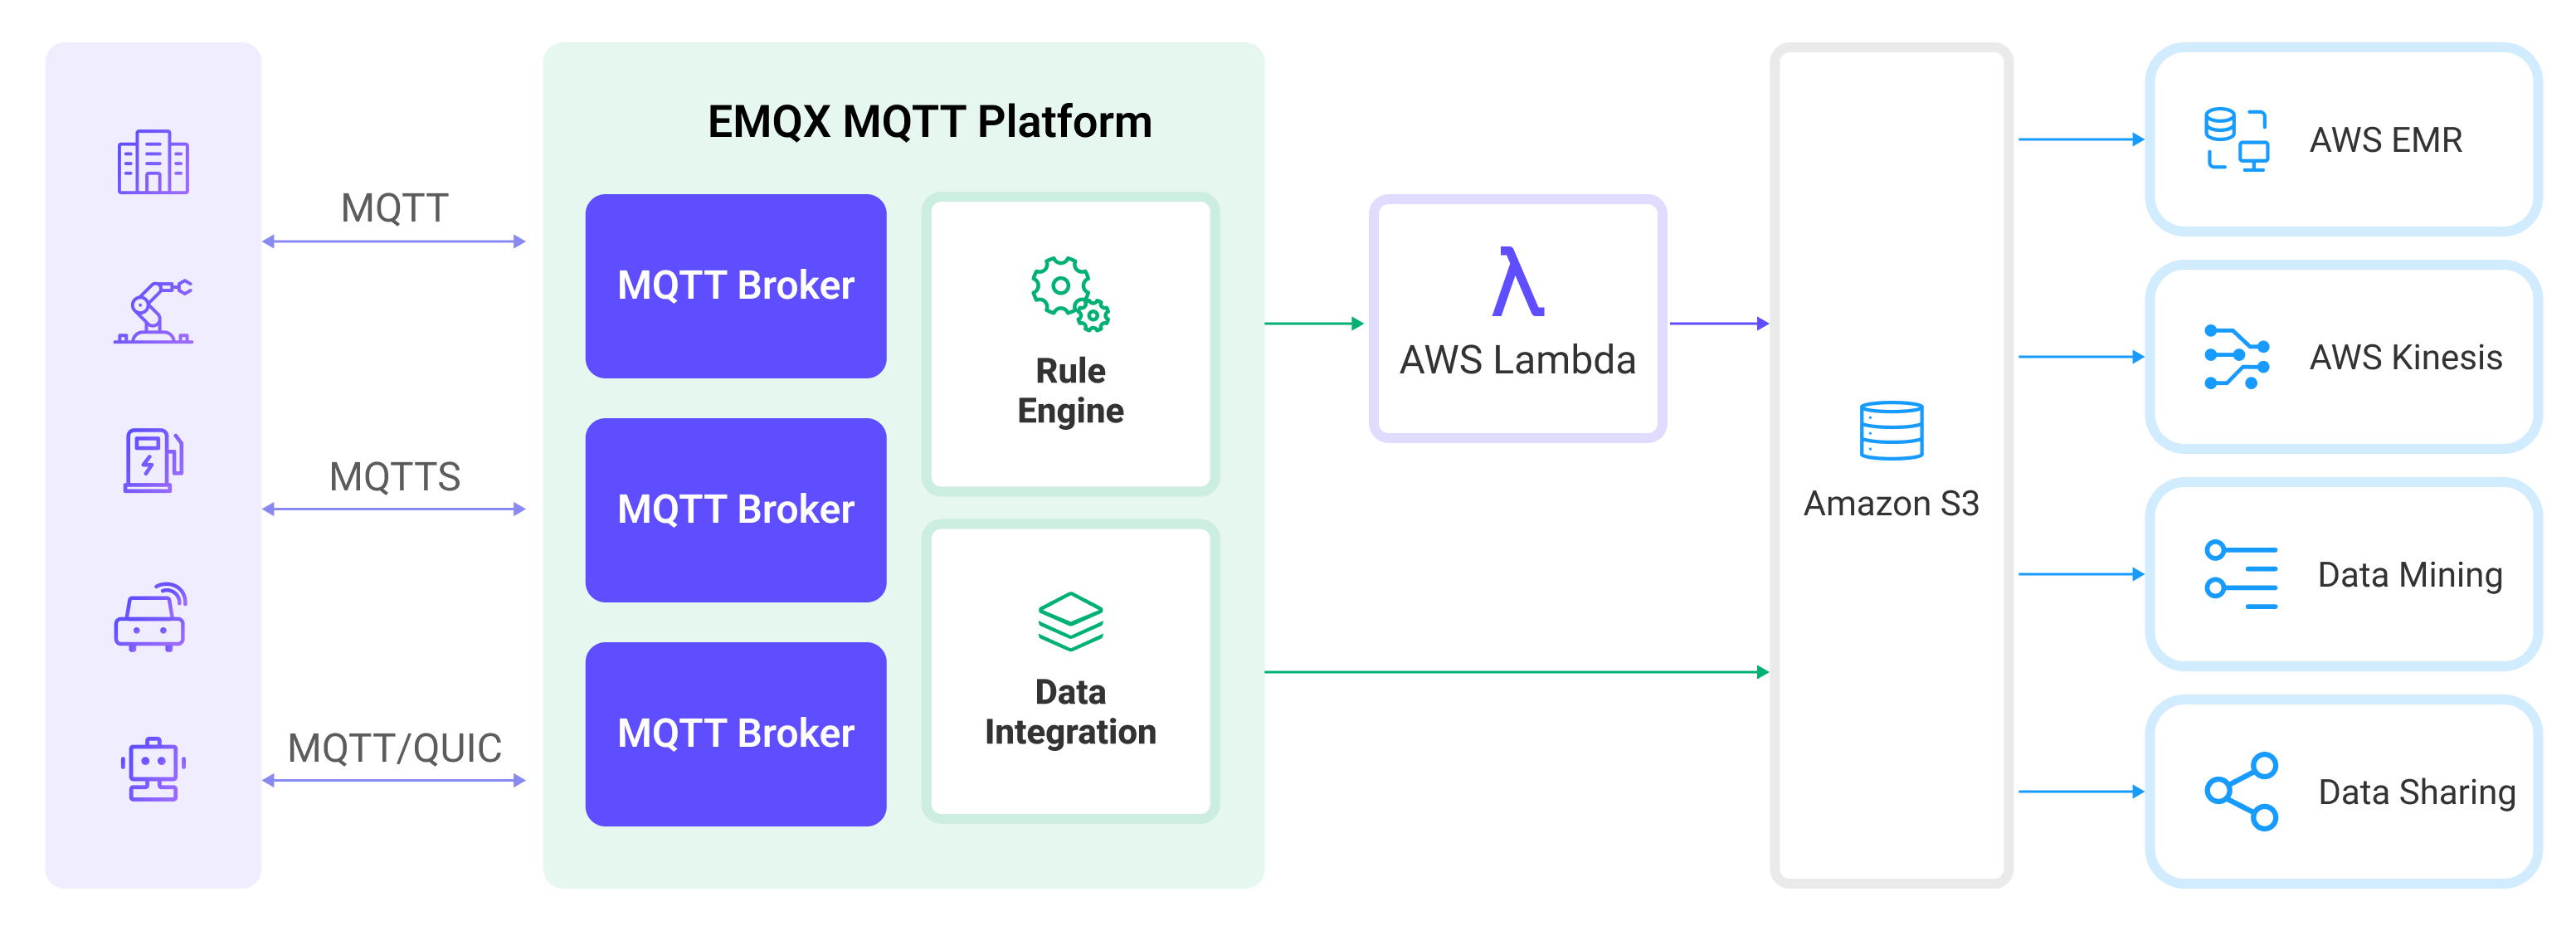
EMQXはルールエンジンとSinkを利用してデバイスのイベントやデータをAmazon S3に転送します。アプリケーションはAmazon S3からデータを読み取り、さらなるデータ活用が可能です。具体的なワークフローは以下の通りです:
- デバイスのEMQX接続:IoTデバイスはMQTTプロトコルで正常に接続されるとオンラインイベントを発生させます。イベントにはデバイスID、送信元IPアドレスなどのプロパティ情報が含まれます。
- デバイスメッセージのパブリッシュと受信:デバイスは特定のトピックを通じてテレメトリや状態データをパブリッシュします。EMQXはメッセージを受信し、ルールエンジン内で照合します。
- ルールエンジンによるメッセージ処理:組み込みのルールエンジンはトピックマッチングに基づき特定のソースからのメッセージやイベントを処理します。対応するルールをマッチさせ、データフォーマット変換、特定情報のフィルタリング、コンテキスト情報の付加などの処理を行います。
- Amazon S3への書き込み:ルールはメッセージをS3に書き込むアクションをトリガーします。Amazon S3 Sinkを使い、処理結果からデータを抽出してS3に送信可能です。メッセージはテキストまたはバイナリ形式で保存でき、複数行の構造化データはCSV、JSON Lines、Parquetファイルにまとめて格納可能です。これはメッセージ内容とSink設定に依存します。
イベントやメッセージデータがAmazon S3に書き込まれた後、Amazon S3に接続してデータを読み取り、以下のような柔軟なアプリケーション開発が可能です:
- データアーカイブ:デバイスメッセージをAmazon S3のオブジェクトとして長期保存し、コンプライアンス要件やビジネスニーズに対応。
- データ分析:S3から分析サービス(例:Snowflake)にデータを取り込み、予知保全、デバイス効率評価などの分析を実施。
特長と利点
EMQXのAmazon S3データ統合を利用することで、以下の特長と利点をビジネスにもたらします:
- メッセージ変換:メッセージはEMQXルール内で高度に処理・変換されてからAmazon S3に書き込まれ、後続の保存や活用が容易になります。
- 柔軟なデータ操作:S3 Sinkを使うことで、特定のデータフィールドをAmazon S3バケットに簡単に書き込めます。バケット名やオブジェクトキーは動的に設定可能で柔軟なデータ保存を実現します。
- 統合されたビジネスプロセス:S3 SinkによりデバイスデータをAmazon S3の豊富なエコシステムアプリケーションと組み合わせられ、データ分析やアーカイブなど多様なビジネスシナリオに対応可能です。
- 低コストの長期保存:データベースと比較して、Amazon S3は高可用性・高信頼性かつコスト効率の良いオブジェクトストレージサービスであり、長期保存に適しています。
これらの特長により、効率的で信頼性が高くスケーラブルなIoTアプリケーションを構築し、ビジネスの意思決定や最適化に役立てられます。
はじめる前に
本節では、EMQXでAmazon S3 Sinkを作成する前の準備について説明します。
前提条件
以下の内容に事前に慣れていることを推奨します:
EMQXの概念:
AWSの概念:
AWS S3が初めての場合、以下の用語を確認してください:
- EC2:AWSの仮想マシンサービス(コンピュートインスタンス)。
- IAM:AWS Identity and Access Management。インスタンスロールはそのインスタンス上で動作するプログラムに一時的な認証情報を発行可能。
- IMDSv2:EC2のインスタンスメタデータサービスv2。トークンベースでより安全にメタデータや一時認証情報を取得可能。
S3バケットの準備
EMQXはAmazon S3およびその他のS3互換ストレージサービスをサポートします。AWSクラウドサービスを利用するか、DockerでMinIOインスタンスをデプロイ可能です。
コネクターの作成
S3 Sinkを追加する前に、対応するコネクターを作成します。
ダッシュボードのIntegration -> Connectorページに移動します。
右上のCreateボタンをクリックします。
コネクタータイプでAmazon S3を選択し、Nextをクリックします。
コネクター名を入力します。名前は文字または数字で始まり、英数字、ハイフン、アンダースコアを含めることができます。例として
my-s3を入力します。接続情報を入力します。
- Amazon S3バケットを使用する場合、以下を入力します:
Host:実際のS3バケット名を含まないS3エンドポイントホストを入力します。標準のAWSリージョナルエンドポイントは
s3.{region}.amazonaws.com形式です(例:s3.us-west-2.amazonaws.com)。AWS PrivateLinkのAmazon S3インターフェースエンドポイントを使う場合は、そのリージョナルまたはゾーンDNS名を入力します(例:
bucket.vpce-0123456789abcdef0-example.s3.us-west-2.vpce.amazonaws.com)。このDNS名のbucketはリテラルのプレフィックスであり、実際のS3バケット名ではありません。実際のバケット名はSinkのBucketフィールドで設定します。EMQX 6.2.4以降は、これらのDNS名から署名用リージョンを推測可能です。Port:
443を入力します。Access Key IDとSecret Access Key:
- AWSで作成したアクセスキーを入力するか、
- EC2上でIAMロールをアタッチしている場合は空欄にします。
詳細はPrepare an S3 Bucketの「Amazon S3」タブを参照してください。
- MinIOを使用する場合、以下を入力します:
- Host:
127.0.0.1を入力。リモートでMinIOを動かしている場合は実際のホストアドレスを入力してください。 - Port:
9000を入力します。 - Access Key IDとSecret Access Key:MinIOで作成したアクセスキーを入力します。
- Host:
Amazon S3またはS3互換サービスに応じて以下のフィールドも設定します:
- Signing Region:EMQX 6.2.4以降で利用可能。S3リクエストや署名付きURLの署名リージョンを指定し、Hostから推測される値を上書きします。空欄の場合はHostから推測、または
us-east-1をデフォルトとします。カスタムドメインなどでリージョン識別子が含まれない場合に設定してください。 - Bucket Access Method:
pathまたはvhostを選択。デフォルトはpathです。pathの場合、リクエストパスにバケット名を含めます。vhostの場合、バケット名をエンドポイントホストの前に付加します。vhost使用時はHostにバケット名を含めず、SinkのBucketフィールドで設定してください。
- Amazon S3バケットを使用する場合、以下を入力します:
その他の設定はデフォルト値を使用します。
Createをクリックする前に、Test ConnectivityをクリックしてコネクターがS3サービスに接続できるかテスト可能です。
最後にCreateボタンをクリックしてコネクター作成を完了します。
これでコネクター作成が完了し、S3サービスに書き込むデータを指定するルールとSinkの作成に進みます。
Amazon S3 Sink付きルールの作成
本節では、EMQXでソースMQTTトピックt/#からのメッセージを処理し、処理結果を設定済みのSinkを通じてS3のiot-dataバケットに書き込むルールの作成方法を示します。
ダッシュボードのIntegration -> Rulesページに移動します。
右上のCreateボタンをクリックします。
ルールIDに
my_ruleを入力し、SQLエディターに以下のルールSQLを入力します:sqlSELECT * FROM "t/#"TIP
SQLに不慣れな場合は、SQL ExamplesやEnable DebugをクリックしてルールSQLの学習や結果テストが可能です。
アクションを追加し、Action Typeドロップダウンから
Amazon S3を選択します。アクションドロップダウンはデフォルトのcreate actionのままにするか、既存のAmazon S3アクションを選択可能です。ここでは新しいSinkを作成してルールに追加します。Sinkの名前と説明を入力します。
コネクタードロップダウンから先に作成した
my-s3コネクターを選択します。ドロップダウン横の作成ボタンをクリックするとポップアップで新規コネクターを素早く作成可能です。必要な設定パラメータはCreate a Connectorを参照してください。Bucketに
iot-dataを入力します。このフィールドは${var}形式のプレースホルダーもサポートしますが、対応するバケット名は事前にS3で作成しておいてください。必要に応じてACLを選択し、アップロードされるオブジェクトのアクセス権限を指定します。
Upload Methodを選択します。2つの方法の違いは以下の通りです:
- Direct Upload:ルールがトリガーされるたびに、設定済みのオブジェクトキーと内容に従ってデータを直接S3にアップロードします。バイナリや大きなテキストデータの保存に適していますが、多数のファイルが生成される可能性があります。
- Aggregated Upload:複数のルールトリガー結果を1つのファイル(例:CSVファイル)にまとめてS3にアップロードします。構造化データの保存に適し、ファイル数を減らし書き込み効率を向上させます。
選択した方法に応じて設定パラメータが異なります。以下のタブから該当する設定を行ってください:
フォールバックアクション(任意):メッセージ配信失敗時の信頼性向上のため、1つ以上のフォールバックアクションを定義可能です。プライマリSinkがメッセージ処理に失敗した場合にトリガーされます。詳細はFallback Actionsを参照してください。
Advanced Settingsを展開し、必要に応じて詳細設定を行います(任意)。詳細はAdvanced Settingsを参照してください。
残りの設定はデフォルト値を使用し、CreateボタンをクリックしてSink作成を完了します。作成成功後はルール作成画面に戻り、新しいSinkがルールアクションに追加されます。
ルール作成画面でCreateボタンをクリックし、ルール作成全体を完了します。
これでルールの作成が完了し、Rulesページで新規ルールを確認でき、**Actions (Sink)**タブで新しいS3 Sinkを確認できます。
また、Integration -> Flow Designerをクリックするとトポロジーを視覚的に確認できます。トポロジーはトピックt/#配下のメッセージがルールmy_ruleで解析され、S3に書き込まれる流れを示します。
Parquetフォーマットオプション
Aggregation Typeをparquetに設定すると、EMQXは集計されたルール結果をApache Parquet形式で保存します。Parquetは列指向かつ圧縮されたファイル形式で、分析処理に最適化されています。
本節ではParquet出力フォーマットの設定可能なオプションを説明します。
Parquetスキーマ(Avro)
このオプションはMQTTメッセージのフィールドをParquetファイルのカラムにマッピングする方法を定義します。EMQXはApache Avroスキーマ仕様を使ってParquetデータの構造を記述します。
以下のいずれかを選択可能です:
スキーマレジストリに存在するAvroスキーマ:EMQXのスキーマレジストリで管理されているAvroスキーマを使用します。
この場合、シリアライズに使うスキーマを識別するSchema Nameの指定も必要です。
TIP
スキーマをレジストリで一元管理し、複数システム間で一貫したスキーマ進化を行いたい場合に推奨します。
Avroスキーマを直接定義:EMQX内でスキーマJSON構造をSchema Definitionフィールドに直接入力します。
例:
json{ "type": "record", "name": "MessageRecord", "fields": [ {"name": "clientid", "type": "string"}, {"name": "timestamp", "type": "long"}, {"name": "payload", "type": "string"} ] }
TIP
ルールSQLで返されるフィールド名やデータ型と一致していることを確認してください。不正または不足があるとParquet書き込み時にシリアライズエラーが発生します。
Parquetデフォルト圧縮
Parquetの各行グループ内のデータページに適用する圧縮アルゴリズムを指定します。圧縮によりストレージ容量を削減し、クエリ時のI/O効率が向上します。
サポート値:
| 値 | 説明 |
|---|---|
snappy(デフォルト) | 高速な圧縮・解凍と良好な圧縮率のバランスを持つアルゴリズム。ほとんどのケースで推奨。 |
zstd | 中程度のCPU使用率で高圧縮率を提供。大規模分析データや長期保存に最適。 |
None | 圧縮を無効化。デバッグ用途や圧縮不要時のみ推奨。 |
Parquet最大行グループサイズ(バイト)
Parquetの行グループの最大サイズ(バイト単位)を指定します。行グループは読み書きの基本単位で、バッファされたデータサイズがこの閾値を超えるとEMQXは現在の行グループをフラッシュし新規行グループを開始します。
- デフォルト値:
128 MB
ガイドライン:
- 値を大きくすると、AthenaやSparkなど分析クエリの読み取り性能が向上します。
- 値を小さくすると、書き込み時のメモリ使用量を抑えられ、小規模データセットに適します。
TIP
Parquetリーダーは行グループ単位でデータを読み込みます。大きな行グループはメタデータのオーバーヘッドを減らし、分析クエリ性能を向上させます。
ルールのテスト
本節では、Direct Upload方式で設定したルールのテスト方法を示します。
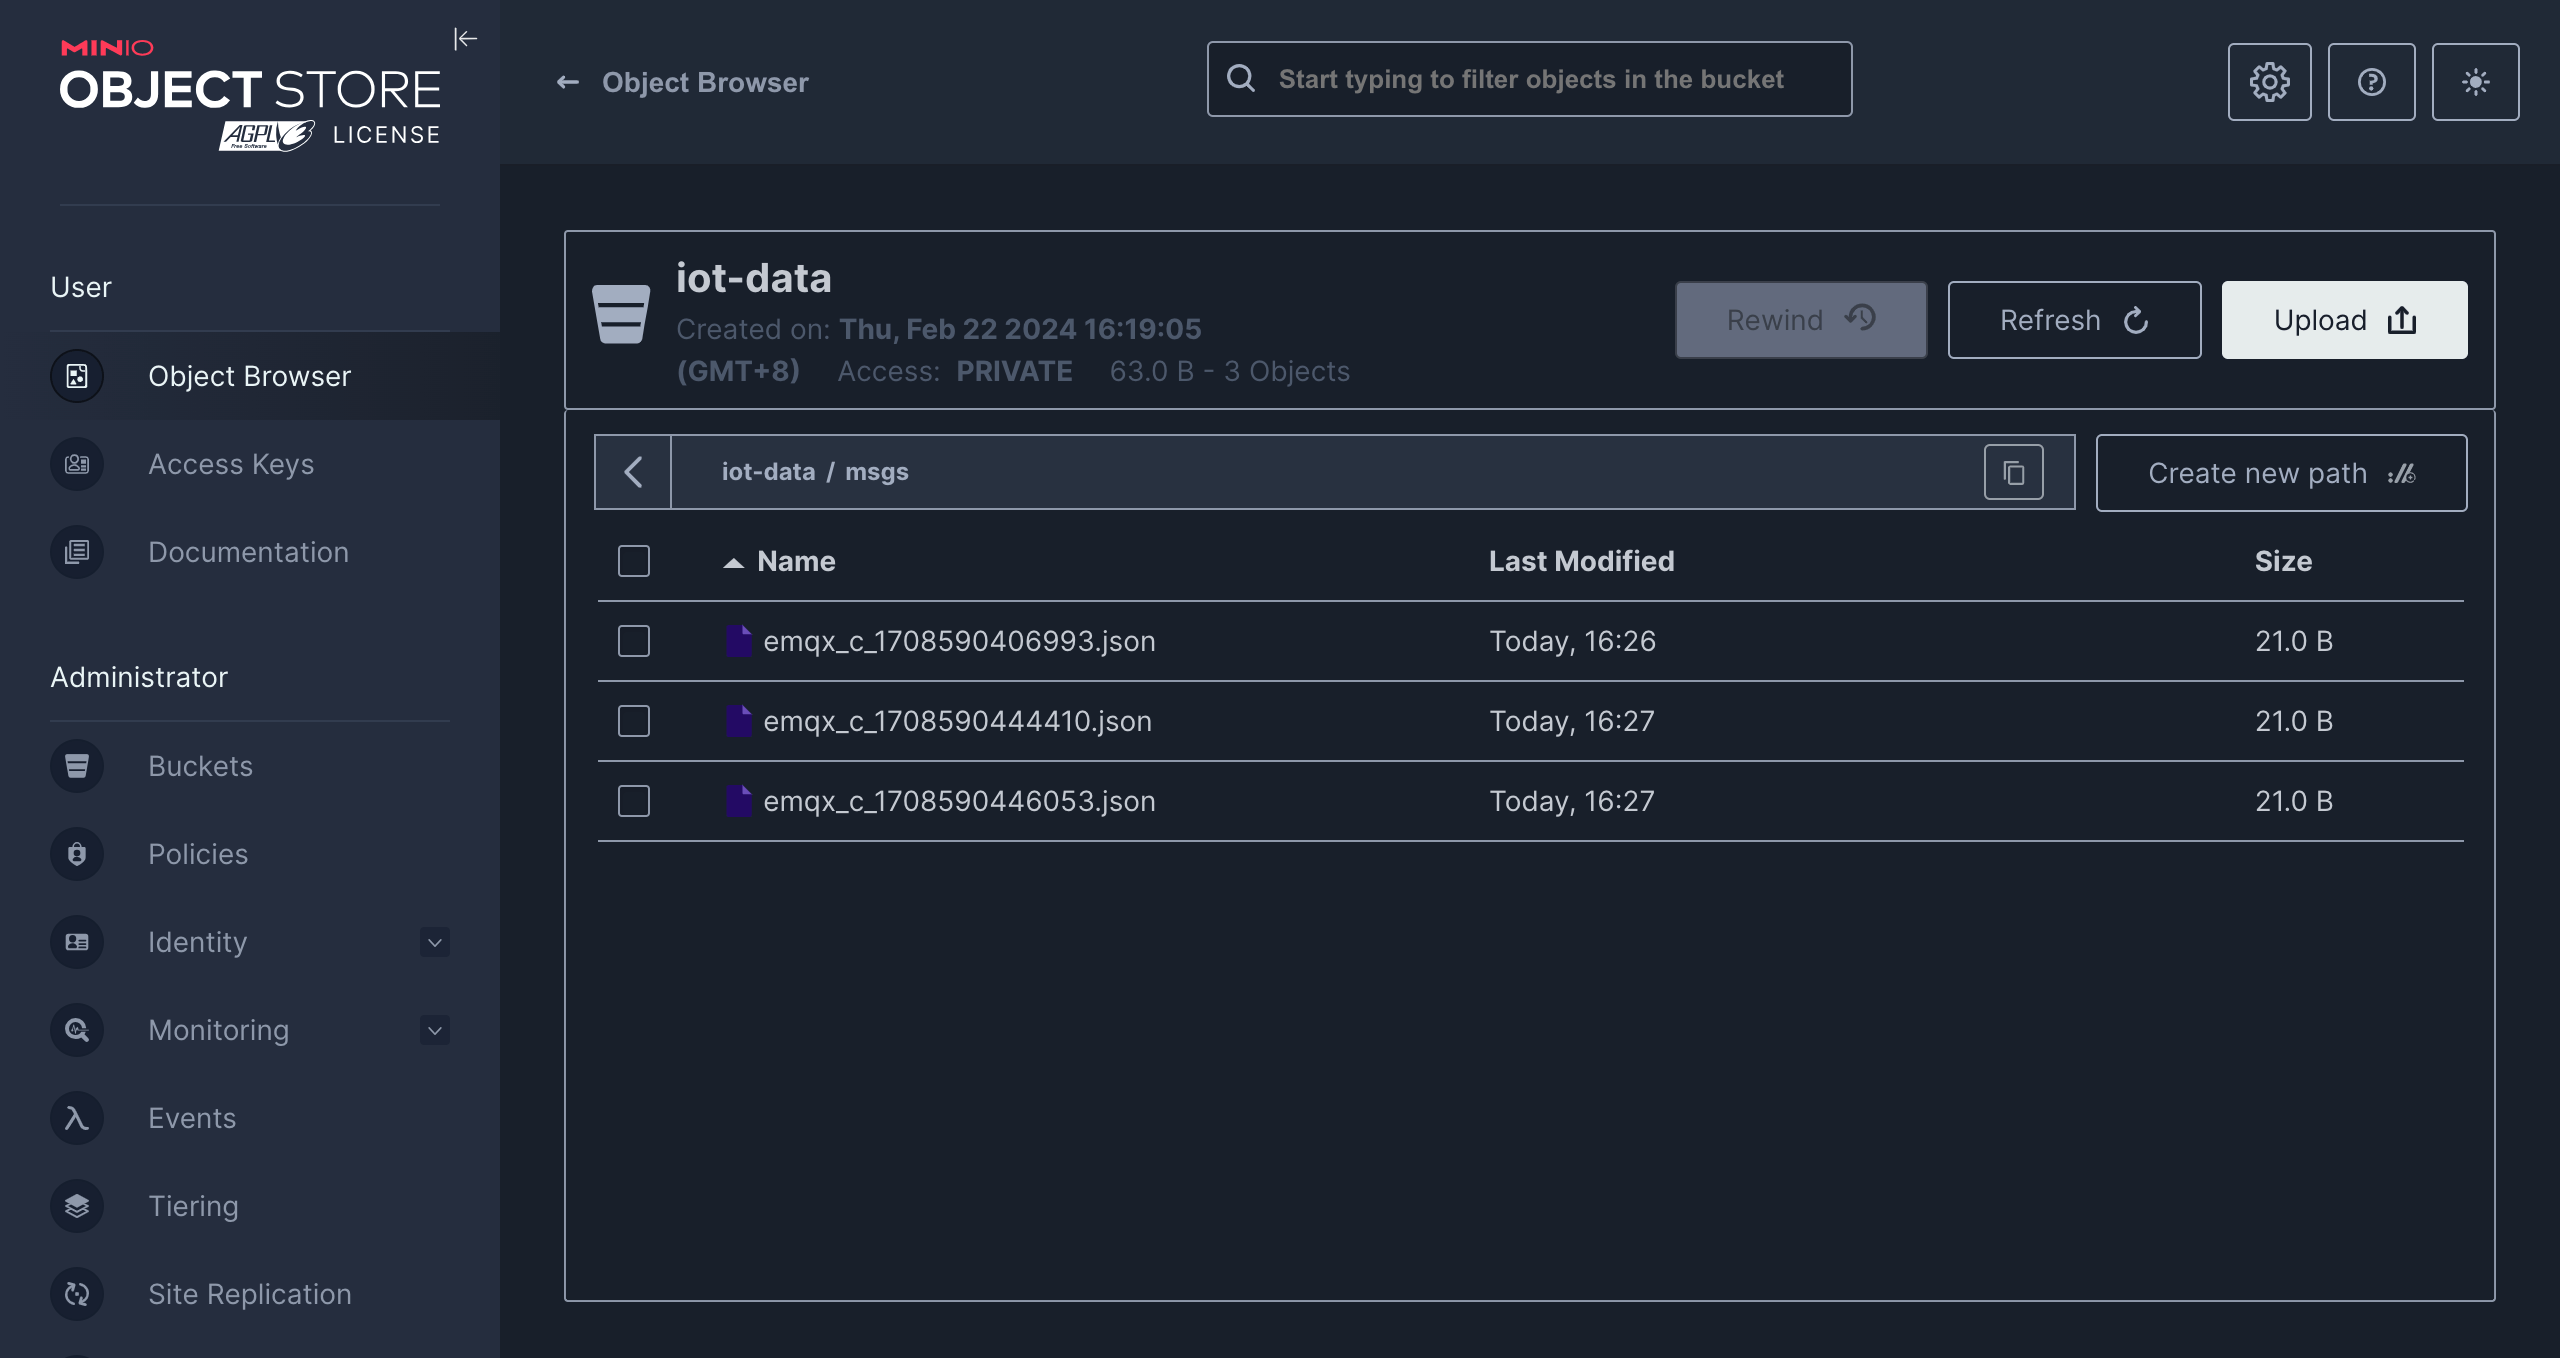
MQTTXを使い、トピックt/1にメッセージをパブリッシュします:
mqttx pub -i emqx_c -t t/1 -m '{ "msg": "hello S3" }'数件メッセージを送信後、MinIOコンソールまたはAmazon S3コンソールで結果を確認します。
詳細設定
本節ではS3 Sinkの詳細設定オプションについて説明します。ダッシュボードのSink設定画面でAdvanced Settingsを展開し、用途に応じて以下のパラメータを調整可能です。
| 項目名 | 説明 | デフォルト値 |
|---|---|---|
| Buffer Pool Size | EMQXとS3間のデータフローを管理するバッファワーカープロセスの数を指定します。これらのワーカーはデータを一時的に保存・処理し、ターゲットサービスへ送信する前のパフォーマンス最適化とスムーズなデータ転送に重要です。 | 16 |
| Request TTL | バッファに入ったリクエストが有効とみなされる最大時間(秒)を指定します。リクエストがこのTTLを超えてバッファに滞留するか、送信後にS3からの応答やアックを受け取れない場合、リクエストは期限切れと判断されます。 | 45 |
| Health Check Interval | SinkがS3との接続状態を自動的にヘルスチェックする間隔(秒)を指定します。 | 15秒 |
| Health Check Interval Jitter | 複数ノードが同時にヘルスチェックを開始する確率を減らすため、基本間隔に加える一様ランダム遅延です。複数のアクションやソースが同一コネクターを共有する場合、ジッターを有効にするとヘルスチェックがずれて実行されます。 | 0ミリ秒 |
| Health Check Timeout | コネクターがS3テーブルとの接続ヘルスチェックを行う際のタイムアウト時間を指定します。 | 60秒 |
| Max Buffer Queue Size | S3 Sinkの各バッファワーカーがバッファリング可能な最大バイト数を指定します。バッファワーカーはデータを一時保存し、S3への送信を効率化する役割を担います。システム性能やデータ転送要件に応じて調整してください。 | 256 MB |
| Query Mode | synchronousまたはasynchronousのリクエストモードを選択し、メッセージ送信を最適化します。非同期モードではS3への書き込みがMQTTメッセージのパブリッシュ処理をブロックしませんが、クライアントがS3到達前にメッセージを受信する可能性があります。 | Asynchronous |
| In-flight Window | 「インフライトキューリクエスト」とは、送信済みだが応答やアックをまだ受け取っていないリクエストを指します。この設定はSinkとS3間の通信で同時に存在可能なインフライトリクエストの最大数を制御します。 Request Modeが asynchronousの場合に重要で、同一MQTTクライアントからのメッセージを厳密に順序処理したい場合は1に設定してください。 | 100 |
| Min Part Size | 集計完了後のパートアップロードの最小チャンクサイズです。アップロード対象データはこのサイズに達するまでメモリに蓄積されます。 | 5MB |
| Max Part Size | パートアップロードの最大チャンクサイズです。S3 Sinkはこれを超えるサイズのパートアップロードを試みません。 | 5GB |