Amazon S3 Tables への MQTT データ取り込み
Amazon S3 Tables は、分析ワークロードに最適化された専用のストレージソリューションです。Apache Iceberg フォーマットで IoT センサーの読み取り値などの表形式データを高性能かつスケーラブルかつ安全に保存できます。
EMQX は Amazon S3 Tables とのシームレスな統合をサポートし、MQTT メッセージを効率的に S3 テーブルバケットに保存できます。この統合により、柔軟かつスケーラブルな IoT データストレージが可能となり、Amazon Athena、Amazon Redshift、Amazon EMR などの AWS サービスを用いた高度な分析や処理を支援します。
本ページでは、EMQX と Amazon S3 Tables のデータ統合について詳しく解説し、ルールおよび Sink の作成方法を実践的に案内します。
動作概要
EMQX の Amazon S3 Tables 統合は標準機能として提供されています。この統合は EMQX のルールエンジンと S3 Tables Sink を活用し、MQTT メッセージを変換して Apache Iceberg フォーマットのテーブルに直接ストリーミングし、S3 テーブルバケットに保存します。これにより長期保存や下流の分析が可能になります。
典型的な IoT シナリオでは以下のように動作します:
- EMQX は MQTT ブローカーとして機能し、デバイスの接続管理、メッセージルーティング、データ処理を担当します。
- Amazon S3 Tables は MQTT メッセージデータを表形式で耐久的かつクエリ可能なストレージとして受け入れます。
- Amazon Athena は Iceberg テーブルを定義し、保存されたデータに対して SQL クエリを実行します。
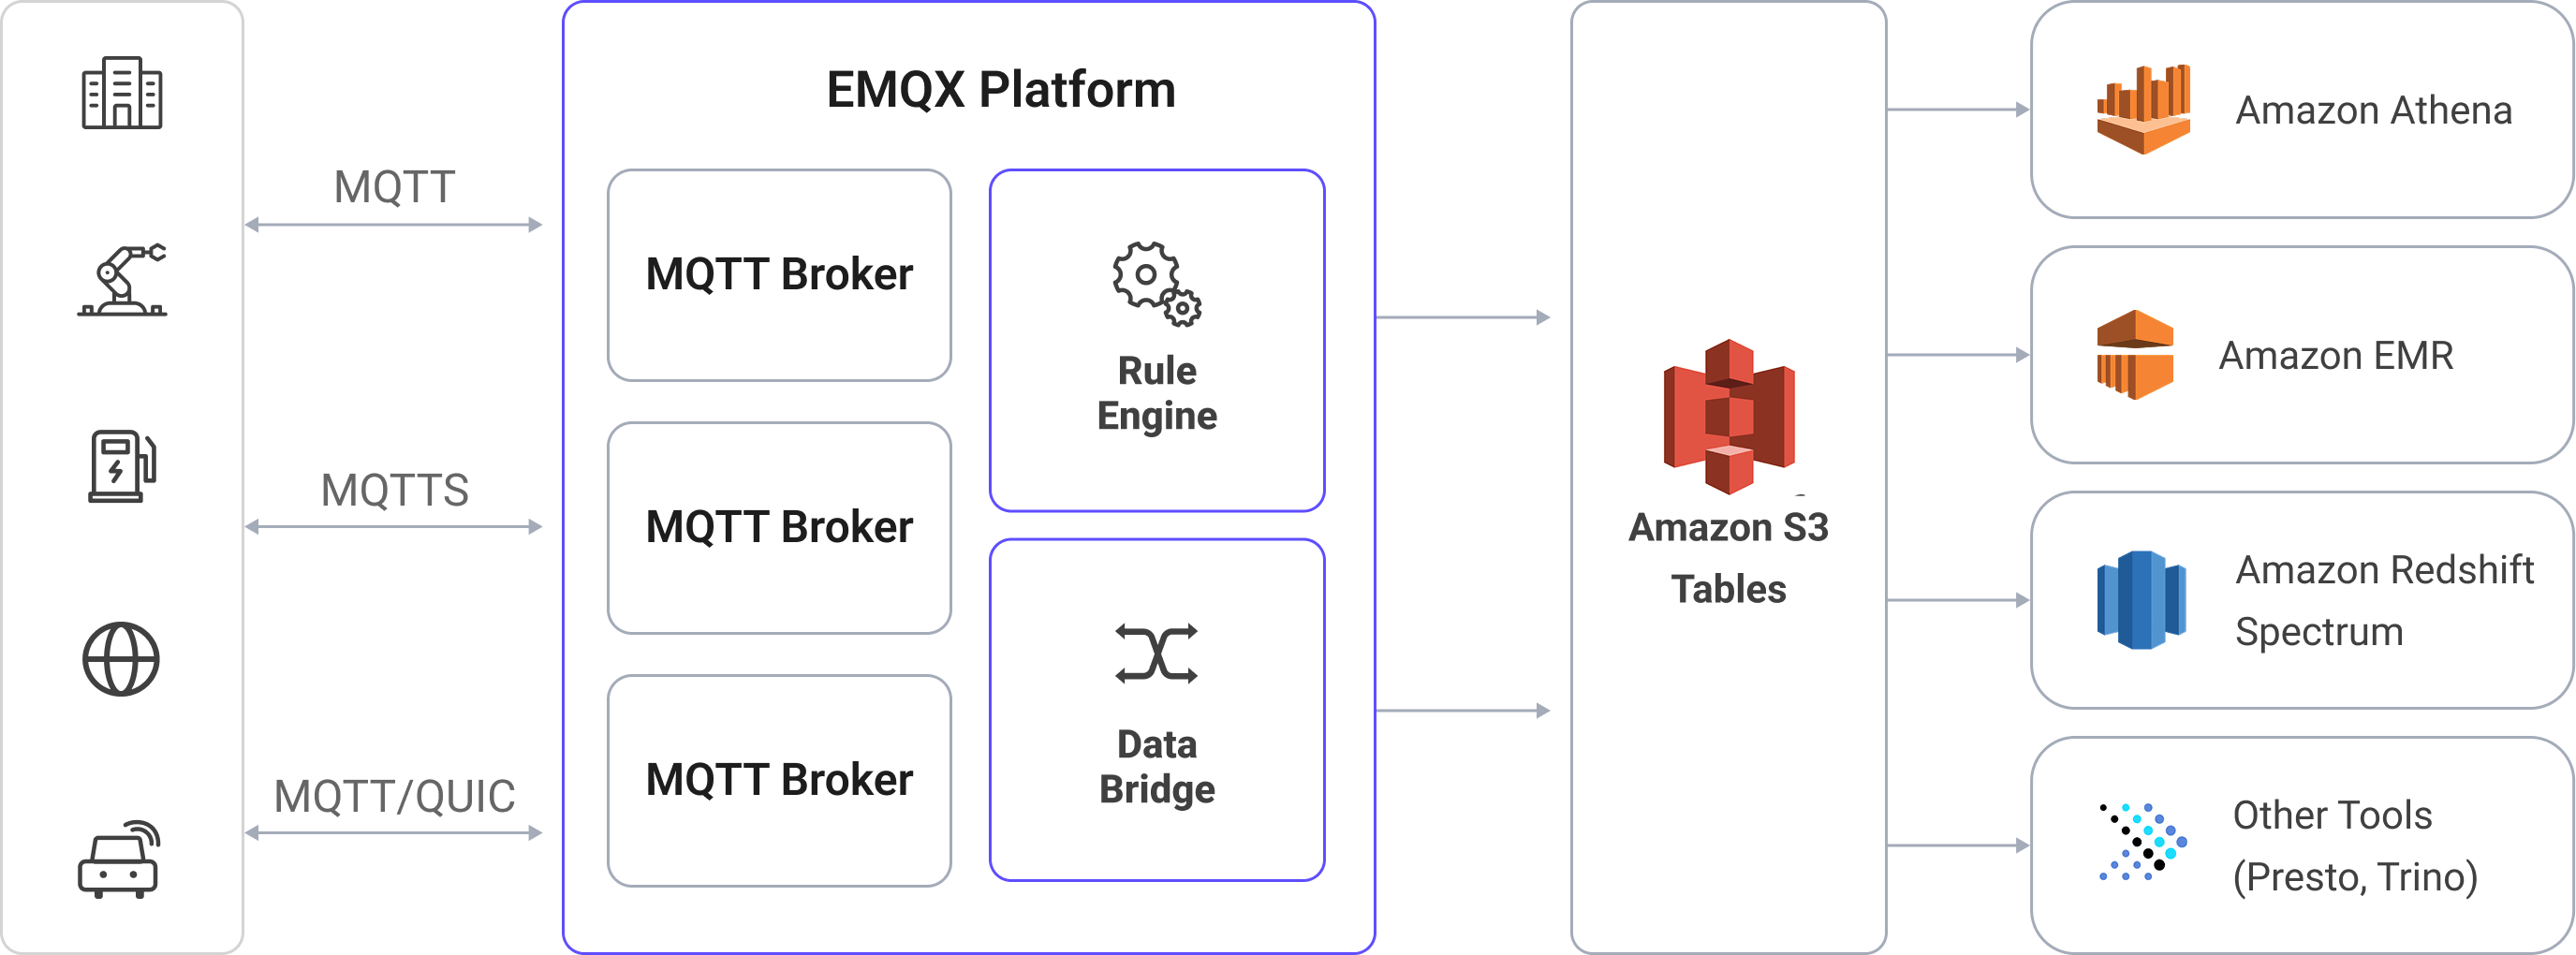
ワークフローは以下の通りです:
- デバイスが EMQX に接続:IoT デバイスが MQTT を介して EMQX に接続し、テレメトリーデータをパブリッシュし始めます。
- メッセージルーティングとルールマッチング:EMQX は組み込みのルールエンジンで受信した MQTT メッセージを定義済みトピックにマッチングし、特定のフィールドや値を抽出します。
- データ変換:EMQX のルールでメッセージペイロードをフィルタリング、変換、または拡張し、ターゲット Iceberg テーブルのスキーマに合わせます。
- Amazon S3 Tables への書き込み:ルールが S3 Tables Sink アクションをトリガーし、変換済みデータをバッチ処理して Iceberg 互換の書き込み API を使い Amazon S3 Tables に送信します。データは Iceberg テーブルのパーティション下に Parquet ファイルとして永続化されます。
- クエリと分析:取り込まれたデータは Amazon Athena でクエリ可能となり、他のデータセットと結合したり、Redshift Spectrum、Amazon EMR、Presto、Trino などのサードパーティ分析エンジンで分析可能です。
特長とメリット
EMQX で Amazon S3 Tables データ統合を利用することで、以下のような特長と利点を得られます:
- リアルタイムストリーム処理:EMQX のルールエンジンにより、MQTT メッセージをリアルタイムに抽出、変換、条件付きルーティングし、S3 Tables へ配信可能です。
- Iceberg ベースの S3 ストレージ:メッセージは Apache Iceberg テーブルに書き込まれ、従来のデータベース不要で SQL ライクなアクセスが可能です。
- 分析ツールとの簡単連携:データが S3 Tables に入ると、Amazon Athena(SQL)、Amazon EMR、Redshift Spectrum、Presto、Trino、Snowflake などでクエリや分析が行えます。
- 柔軟かつコスト効率の良いストレージ:Amazon S3 は高耐久かつ低コストのオブジェクトストレージを提供し、アーカイブ、コンプライアンス、時系列分析に最適です。
はじめる前に
ここでは EMQX で Amazon S3 Tables Sink を作成するための準備について説明します。
前提条件
以下の内容に慣れていることを推奨します:
EMQX の概念:
AWS の概念:
AWS S3 Tables に不慣れな場合、以下の主要用語を確認してください:
- EC2:AWS の仮想マシンサービス(コンピュートインスタンス)。
- IAM:AWS Identity and Access Management。インスタンスロールはそのインスタンス上のプログラムに一時的な認証情報を発行可能。
- IMDSv2:EC2 の Instance Metadata Service v2。トークンベースでより安全にメタデータや一時認証情報を取得。
- Table Bucket:S3 Tables で Iceberg ベースのテーブルデータとメタデータを格納する専用の S3 バケット。
- Amazon Athena:Amazon S3 に保存されたデータに対して直接 SQL クエリを実行できるサーバレスクエリエンジン。
CREATE TABLEなどの DDL 文もサポート。 - Catalog:Athena のメタデータコンテナで、データベース(ネームスペース)やテーブルを管理。
- Database (Namespace):Catalog 配下の論理的なテーブルグループ。
- Iceberg Table:高性能でトランザクション対応のデータレイク向けテーブルフォーマット。スキーマ進化、パーティションプルーニング、タイムトラベルクエリをサポート。
デプロイ前提条件と認証情報の取得方法
S3 Tables コネクターは認証情報の取得方法を2通りサポートしています。EMQX のデプロイ環境に応じて選択してください:
オプション1:アクセスキーを手動設定コネクター作成時に Access Key ID と Secret Access Key を入力します。これらの認証情報は対象の S3 Tables と Athena への必要な権限を持つものにしてください。ローカル環境、コンテナ、Kubernetes、非 AWS クラウド、またはインスタンスロールが付与されていない EC2 で適しています。
IAM ユーザーのアクセスキー作成・管理方法は AWS ドキュメントを参照してください。
オプション2:一時認証情報を自動取得(EC2 のみ) EMQX が AWS EC2 インスタンス上で動作し、そのインスタンスに必要な権限を持つ IAM ロールがアタッチされている場合、コネクターの Access Key ID と Secret Access Key を空欄にできます。EMQX は IMDSv2 API を使ってそのロールに紐づく一時認証情報を取得します。
EC2 インスタンスに IAM ロールを割り当てる方法は AWS ドキュメントを参照してください。
注意事項
- インスタンスロールに対象の S3 Tables(バケット/テーブル)と Athena への十分な権限があることを確認してください。権限不足の場合、Test Connectivity が失敗します。
- 一時認証情報管理には EC2 インスタンスにアタッチされた IAM ロールの使用を推奨します。EC2 以外やロールがない場合はオプション1でアクセスキーを手動入力してください。
S3 Tables バケットの準備
EMQX で Sink を作成する前に、AWS S3 Tables 側で MQTT データの受け先を準備します。以下が必要です:
- 実際のデータファイルを保存する Table Bucket
- 関連テーブルを論理的にグループ化する Namespace
- 構造化された MQTT データを受け入れる Iceberg ベースの Table
AWS マネジメントコンソールにログインします。
S3 サービスに移動し、左のナビゲーションペインで Table buckets をクリックします。
Create table bucket をクリックし、テーブルバケット名(例:
mybucket)を入力して Create table bucket をクリックします。バケット作成後、そのバケットをクリックしてテーブル一覧に移動します。
Create table with Athena をクリックします。ポップアップでネームスペースの指定を求められます。
Create a namespace を選択し、ネームスペース名を入力して作成を確定します。
ネームスペース作成後、再度 Create table with Athena をクリックします。
Iceberg テーブルのスキーマを定義します:
Query table with Athena をクリックし、クエリエディタを開きます。
- Catalog セレクターでカタログ(例:バケット名が
mybucketの場合はs3tablescatalog/mybucket)を選択。 - Database セレクターで先ほど作成したネームスペースを選択。
- Catalog セレクターでカタログ(例:バケット名が
以下の DDL を実行してテーブルを作成し、テーブルタイプが
ICEBERGに設定されていることを確認します。例:sqlCREATE TABLE testtable ( c_str string, c_long int ) TBLPROPERTIES ('table_type' = 'ICEBERG');これは EMQX からの構造化された MQTT データを格納する Iceberg ベースのテーブルを定義します。
テーブルが正しく作成されて空であることを確認するため、以下を実行します:
sqlselect * from testtableTIP
Athena で SQL を実行する際は、必ず正しい Catalog と Database(ネームスペース)が選択されていることを確認してください。これにより、意図した S3 テーブルバケット内にテーブルが作成されます。
コネクターの作成
S3 Tables Sink を追加する前に、対応するコネクターを作成します。
ダッシュボードの Integration -> Connector ページに移動します。
右上の Create ボタンをクリックします。
コネクタータイプで S3 Tables を選択し、次へ進みます。
コネクター名を入力します。名前は英数字で始まり、英数字、ハイフン、アンダースコアを含めることができます。ここでは例として
my-s3-tablesと入力します。接続情報を入力します:
- S3Tables ARN:S3 テーブルバケットの Amazon Resource Name (ARN) を入力します。AWS コンソールの Table buckets セクションで確認可能です。
- Access Key ID と Secret Access Key(任意):
- 手動設定の場合:S3 Tables と Athena へのアクセス権限を持つ IAM ユーザーまたはロールの AWS 認証情報を入力します。
- 自動取得の場合:EMQX が AWS EC2 インスタンス上で動作し、必要な権限を持つ IAM ロールがアタッチされている場合は空欄にできます。EMQX は IMDSv2 を使い一時認証情報を自動取得します。デプロイ前提条件と認証情報の取得方法を参照してください。
- Enable TLS:S3 Tables への接続時は TLS がデフォルトで有効です。詳細は TLS for External Resource Access を参照してください。
- Health Check Timeout:コネクターが S3 Tables との接続の自動ヘルスチェックを行う際のタイムアウト時間を指定します。
その他の設定はデフォルト値のままにします。
Create をクリックする前に、Test Connectivity を押してコネクターが S3 Tables サービスに接続できるか確認できます。
ページ下部の Create ボタンをクリックしてコネクター作成を完了します。
これでコネクター作成が完了し、次にルールと Sink を作成して S3 Tables への書き込みデータを指定します。
Amazon S3 Tables Sink を使ったルールの作成
ここでは、ソース MQTT トピック t/# からのメッセージを処理し、処理結果を先ほど作成した S3 Tables バケット mybucket に書き込むルールの作成方法を示します。
ダッシュボードの Integration -> Rules ページに移動します。
右上の Create ボタンをクリックします。
ルール ID に
my_ruleを入力し、SQL エディタに以下のルール SQL を入力します:sqlSELECT payload.str as c_str, payload.int as c_long FROM "t/#"TIP
SQL に不慣れな場合は、SQL Examples をクリックし、Enable Debug を有効にしてルール SQL の結果を学習・テストできます。
TIP
出力フィールドは Iceberg テーブルのスキーマと一致させてください。必須カラムが欠落または名前が異なると、データのテーブルへの追加に失敗する場合があります。
アクションを追加し、Action Type ドロップダウンから
S3 Tablesを選択します。アクションのドロップダウンはデフォルトのcreate actionのままにするか、既存の S3 Tables アクションを選択します。ここでは新しい Sink を作成してルールに追加します。Sink 名と任意の説明を入力します。
Connector ドロップダウンから先ほど作成した
my-s3-tablesコネクターを選択します。新しいコネクターを素早く定義したい場合は、ドロップダウン横の Create ボタンをクリックしてください。コネクターの作成を参照してください。Sink の設定を行います:
- Namespace:テーブルが存在するネームスペース。複数セグメントの場合はドット区切りで指定(例:
my.name.space)。 - Table:データを追加する Iceberg テーブル名(例:
testtable)。 - Max Records:S3 に書き込む前にバッチ処理する最大レコード数。到達すると即座にバッチをフラッシュしてアップロードします。
- Time Interval:Max Records に達していなくても、指定ミリ秒経過でバッチをフラッシュする最大待機時間。
- Data File Format:S3 にバッチ化された MQTT メッセージを保存するデータファイルのフォーマット。指定可能な値:
avro:(デフォルト)Avro フォーマットでレコードを保存。行ベースでストリームデータやスキーマ進化に適しています。parquet:Apache Parquet フォーマットで保存。列ベースで大規模データの分析クエリに最適化。
- Namespace:テーブルが存在するネームスペース。複数セグメントの場合はドット区切りで指定(例:
フォールバックアクション(任意):メッセージ配信失敗時の信頼性向上のため、1つ以上のフォールバックアクションを定義できます。詳細は フォールバックアクション を参照してください。
Advanced Settings を展開し、必要に応じて詳細設定を行います(任意)。詳細は Advanced Settings を参照してください。
その他の設定はデフォルト値のままにし、Create ボタンをクリックして Sink 作成を完了します。作成成功後、ルール作成画面に戻り、新しい Sink がルールアクションに追加されます。
ルール作成画面で Create ボタンをクリックし、ルール作成を完了します。
これでルールの作成が完了しました。Rules ページで新規ルールを確認でき、Actions (Sink) タブで新しい S3 Tables Sink を確認できます。
また、Integration -> Flow Designer をクリックするとトポロジーが表示され、トピック t/# のメッセージがルール my_rule によって解析され S3 Tables に書き込まれる流れを視覚的に確認できます。
ルールのテスト
ここでは、S3 Tables Sink を設定したルールのテスト方法を示します。
MQTTX を使ってトピック
t/1にメッセージをパブリッシュします:bashmqttx pub -i emqx_c -t t/1 -m '{ "str": "hello S3 Tables", "int": 123 }'このメッセージは
payload.strとpayload.intフィールドを含み、ルール SQL とテーブルスキーマに一致しています。Rules ページでルールのメトリクスと Sink の状態を監視します。新規の受信メッセージと送信メッセージが1件ずつあるはずです。
Athena クエリエディタを開き、正しい Catalog(例:
s3tablescatalog/mybucket)と Database(ネームスペース)が選択されていることを確認します。以下の SQL クエリを実行します:
sqlSELECT * FROM testtable以下のような行が表示されるはずです:
c_str c_long hello S3 Tables 123
Advanced Settings
ここでは S3 Tables Sink の詳細設定オプションについて説明します。ダッシュボードで Sink を設定する際に Advanced Settings を展開し、用途に応じて以下のパラメータを調整できます。
| フィールド名 | 説明 | デフォルト値 |
|---|---|---|
| Min Part Size | マルチパートアップロードの最小パートサイズです。 このサイズに達するまでアップロードデータはメモリに蓄積されます。 | 5 MB |
| Max Part Size | マルチパートアップロードの最大パートサイズです。 S3 アップローダーはこのサイズを超えるパートをアップロードしません。 | 5 GB |
| Buffer Pool Size | EMQX と S3 Tables 間のデータフローを管理するバッファワーカープロセスの数を指定します。これらのワーカーはデータを一時的に保存・処理し、ターゲットサービスへの送信を最適化しスムーズなデータ転送を実現します。 | 16 |
| Request TTL | バッファに入ったリクエストが有効とみなされる最大秒数を指定します。リクエストがこの TTL を超えてバッファに滞留するか、送信後に S3 Tables からの応答やアックがタイムリーに得られない場合、リクエストは期限切れと判断されます。 | 45 秒 |
| Health Check Interval | Sink が S3 Tables との接続状態を自動的にヘルスチェックする間隔(秒)を指定します。 | 15 秒 |
| Health Check Interval Jitter | ヘルスチェック間隔に加える一様ランダム遅延(ミリ秒)です。複数ノードが同時にヘルスチェックを開始する確率を減らします。複数のアクションやソースが同じコネクターを共有する場合に有効です。 | 0 ミリ秒 |
| Health Check Timeout | コネクターが S3 Tables との接続の自動ヘルスチェックを行う際のタイムアウト時間を指定します。 | 60 秒 |
| Max Buffer Queue Size | S3 Tables Sink の各バッファワーカーがバッファリング可能な最大バイト数を指定します。バッファワーカーはデータを一時保存し、効率的にデータストリームを処理します。システム性能やデータ転送要件に応じて調整してください。 | 256 MB |
| Batch Size | EMQX から S3 Tables へ一度に転送するデータバッチの最大レコード数を指定します。サイズを調整することでデータ転送の効率と性能を最適化できます。1 に設定するとレコードを個別送信し、バッチ化しません。 | 1000 |
| Query Mode | メッセージ送信を最適化するため、synchronous(同期)または asynchronous(非同期)モードを選択できます。非同期モードでは S3 Tables への書き込みが MQTT メッセージのパブリッシュ処理をブロックしませんが、クライアントがメッセージを受信してもまだ S3 Tables に到達していない可能性があります。 | Asynchronous |
| In-flight Window | 「インフライトキューリクエスト」とは、送信済みだがまだ応答やアックを受け取っていないリクエストを指します。この設定は Sink と S3 Tables 間の通信で同時に存在可能なインフライトリクエストの最大数を制御します。 Request Mode が asynchronous の場合に特に重要で、同一 MQTT クライアントからのメッセージを厳密に順序処理したい場合は 1 に設定してください。 | 100 |