GPT-Realtime 概要
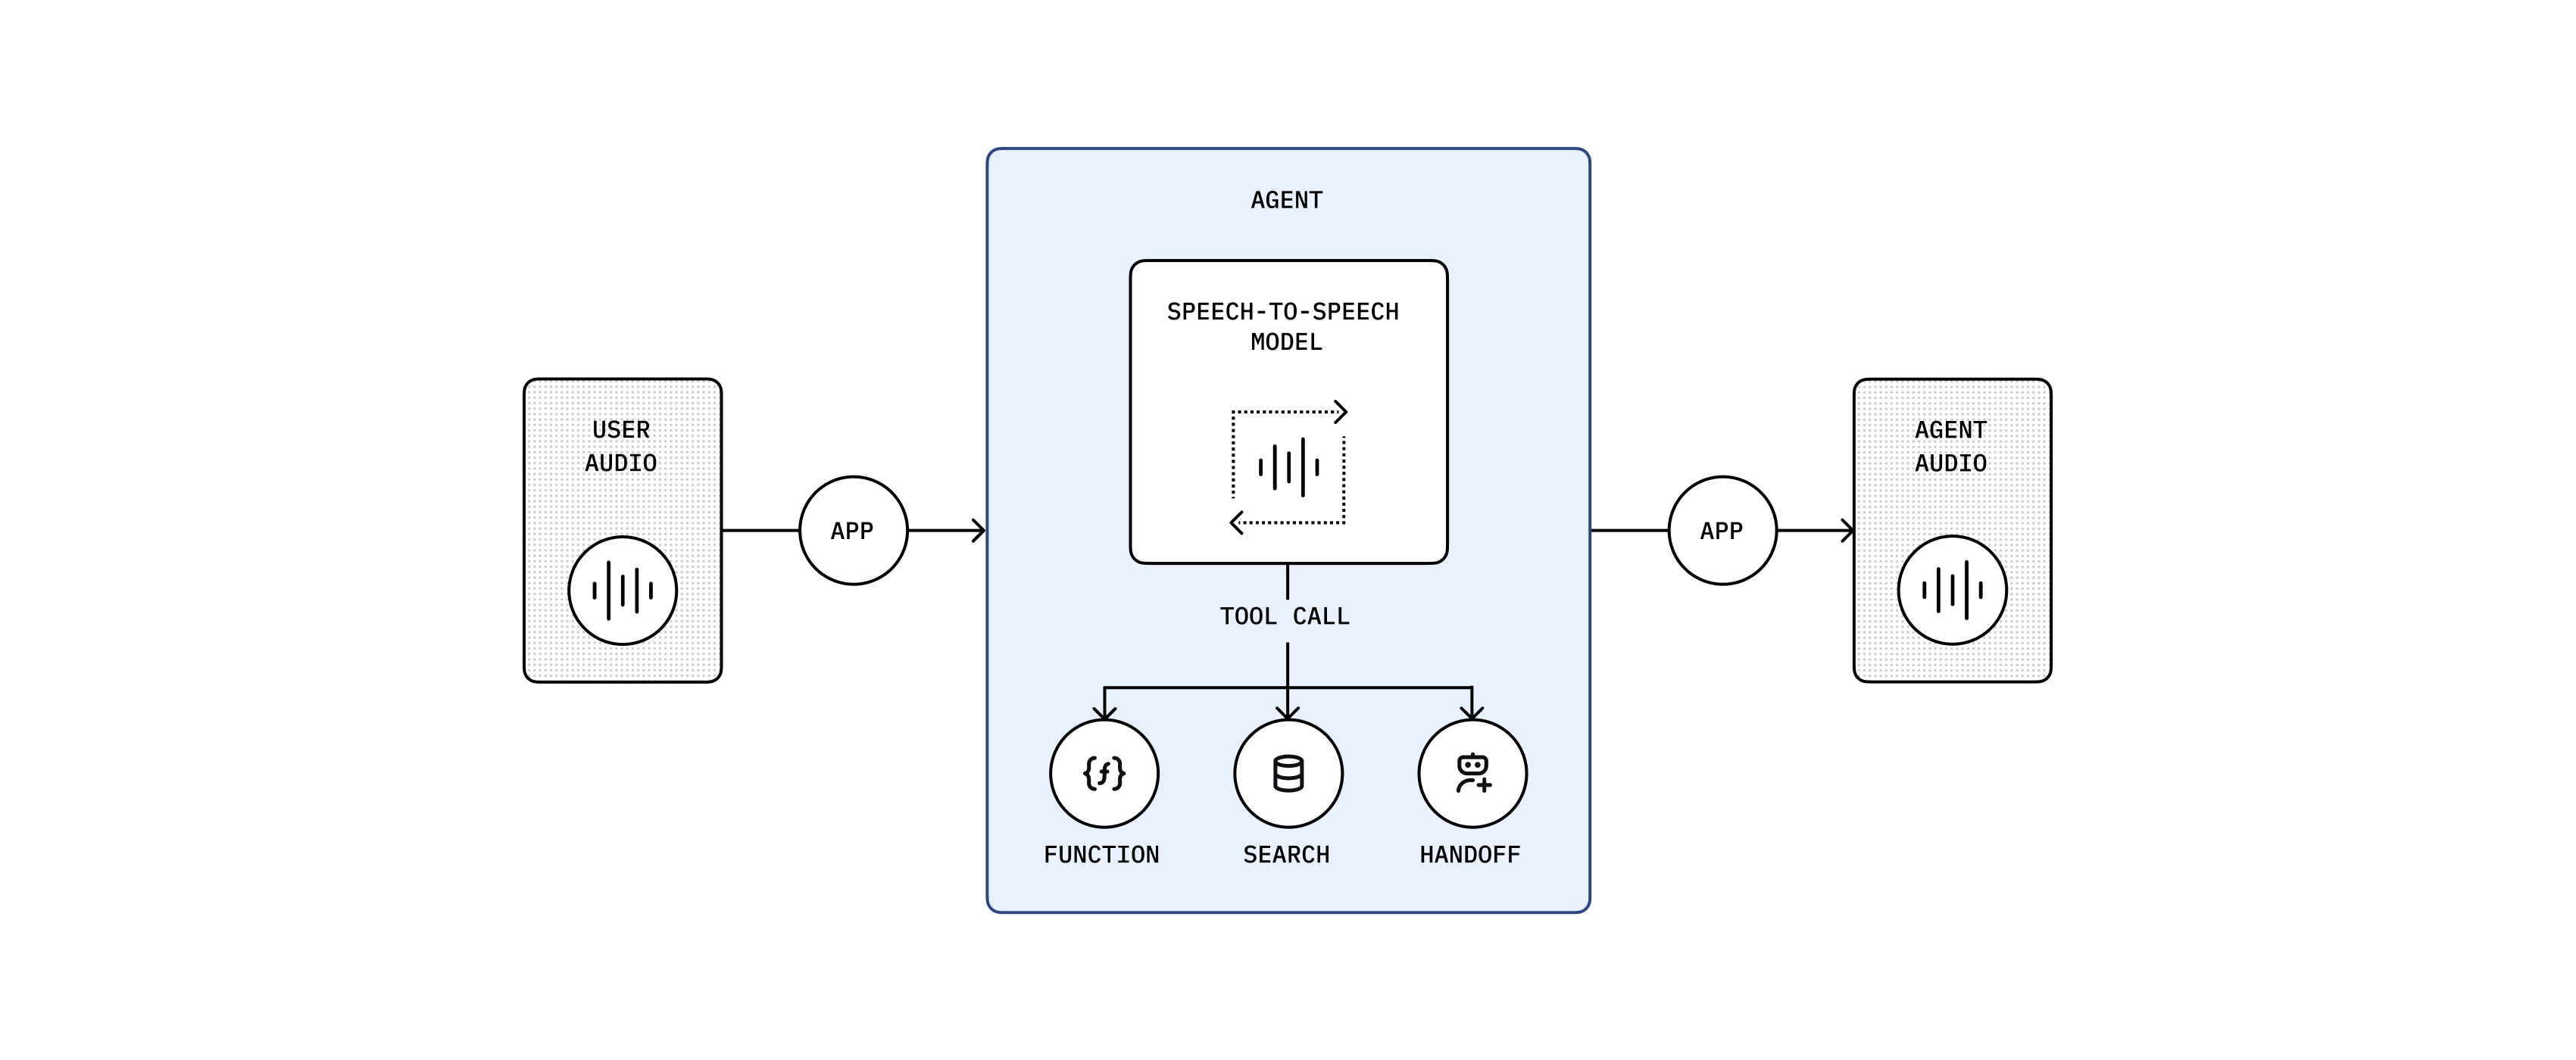
GPT-Realtime は、OpenAI が開発したマルチモーダルのリアルタイムモデルで、ライブの音声入力を受け取り、リアルタイムで音声出力を生成できます。大規模な音声データセットでトレーニングされており、自然な人間の会話パターンに密接に連動するよう設計されています。
主な特徴は以下の通りです:
- プロトコル:WebRTC、WebSocket、SIP をサポートし、テキストおよび音声入力をリアルタイムで処理し、レスポンスを継続的にストリーミングします。
- 会話体験:低レイテンシ、自然で流暢な音声合成、会話中の複数の割り込みに対する堅牢な対応で、人間の対話に近い体験を実現します。
- 関数呼び出しとツール:関数呼び出しおよび MCP ツールをサポートします。
- 開発者体験:WebRTC 統合のために、2 つのレベルの統合を提供しています:
- Voice Agents SDK:すぐに使える高レベルの抽象化機能を備えています。
- WebRTC SDK:より柔軟でカスタマイズ可能な低レベルの音声/映像トランスポートを提供します。
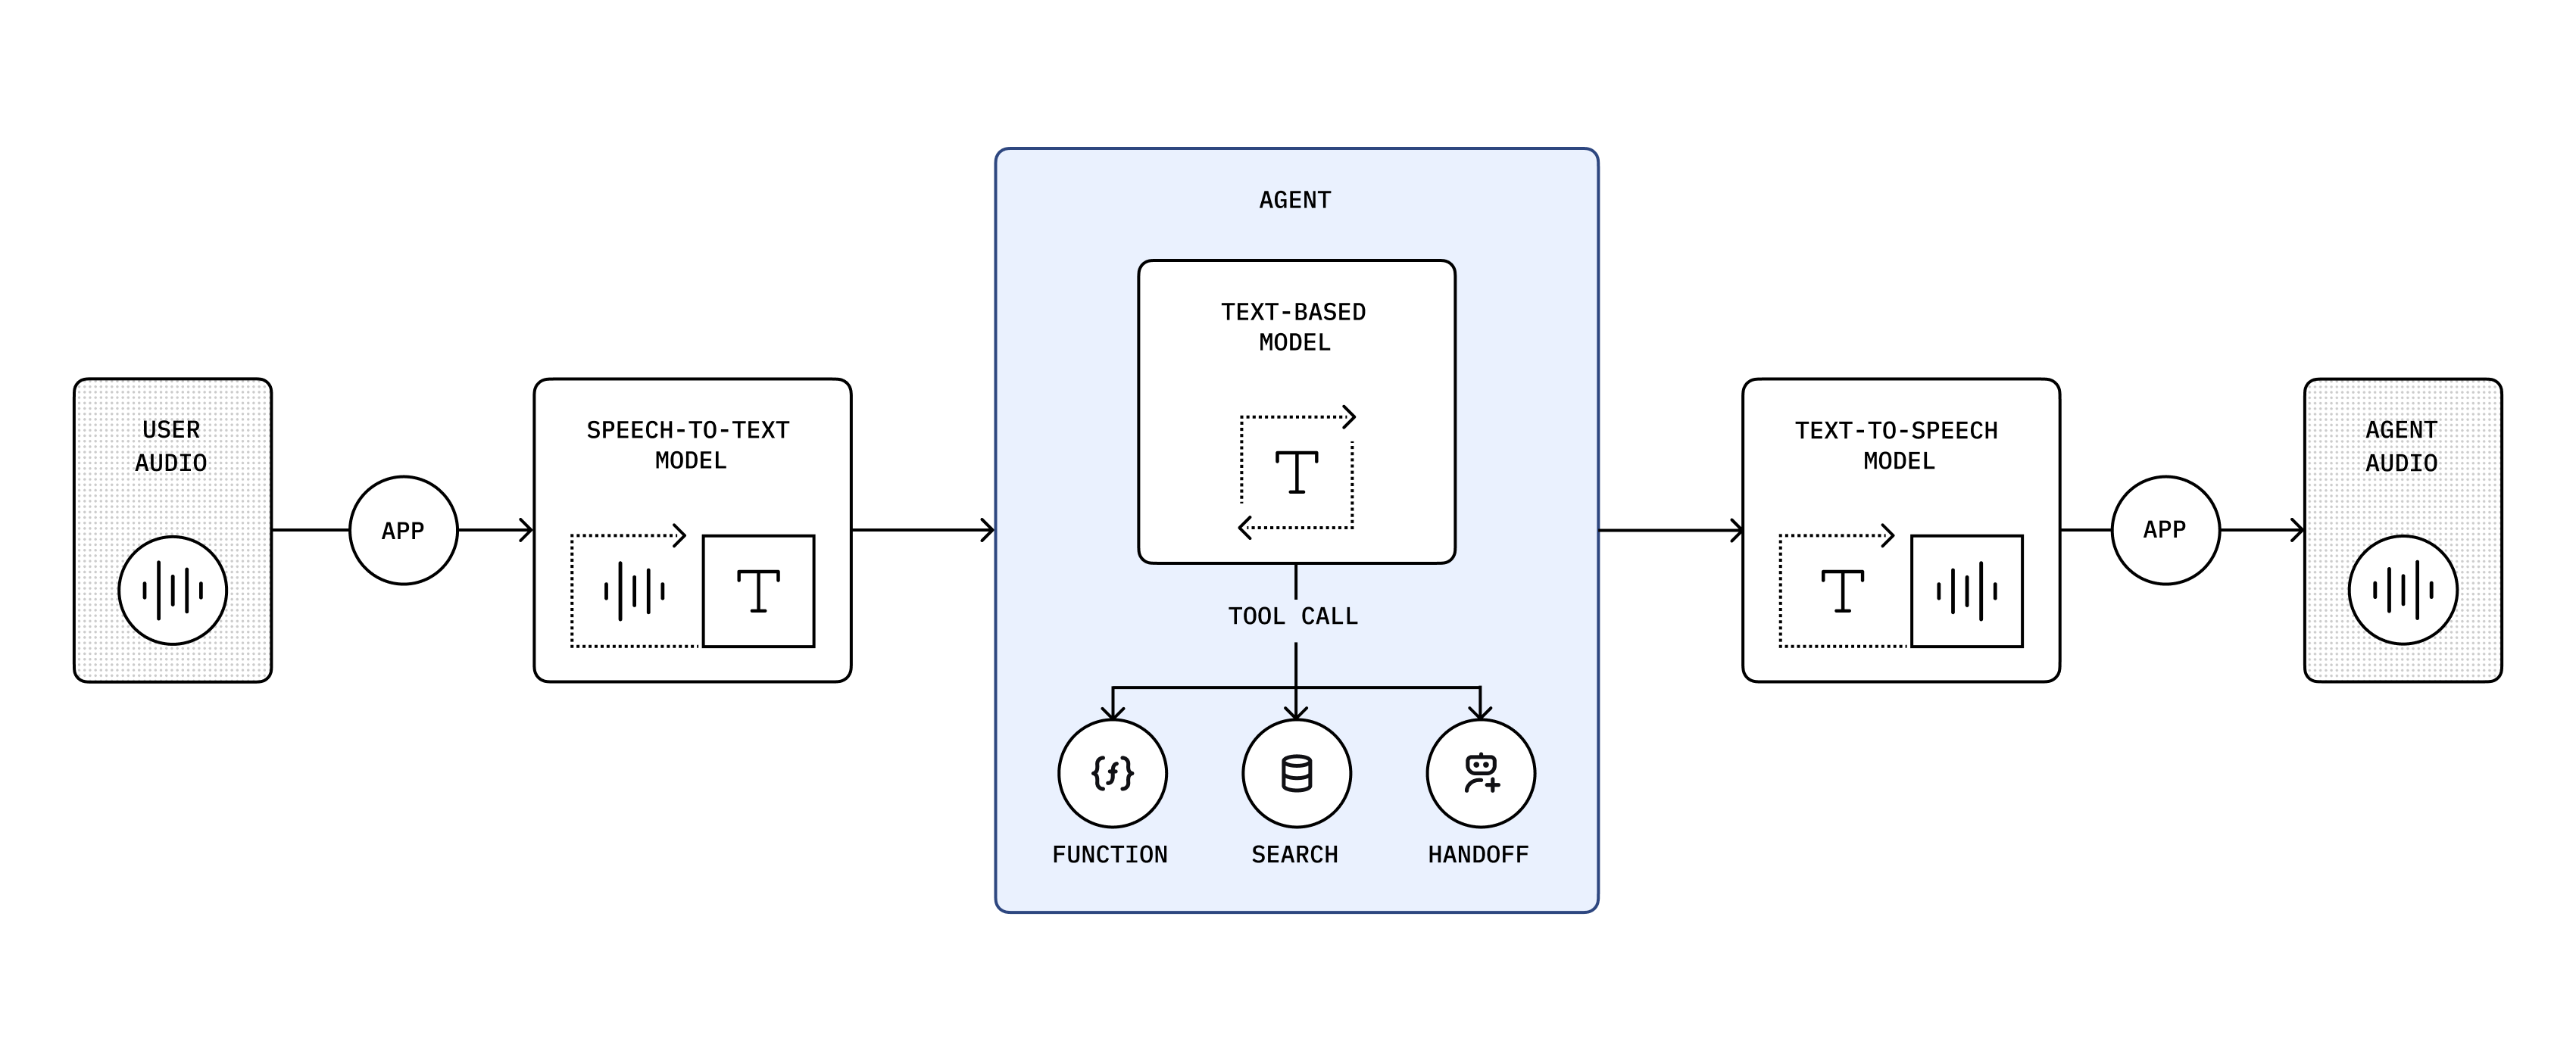
複数モデルを用いた従来の RTC リアルタイム音声パイプライン
従来の RTC リアルタイム音声ソリューションでは、音声対話を実現するために複数種類のモデルを連結して使用するのが一般的です。音声はまずテキストに書き起こされ、大規模言語モデルで処理され、最後に音声合成されてユーザーにストリーミングされます。
GPT-Realtime:単一モデルによる統合機能
GPT-Realtime は複数モデルの連結を不要にします。音声から音声への一連の処理を単一モデルで完結させることで、エンドツーエンドのレイテンシを大幅に低減しています。