将 MQTT 数据写入到 Amazon S3 表类数据存储服务中
注意
Amazon S3 Tables 数据集成功能仅适用于 EMQX 5.91 版本以及之后的专有版部署。
Amazon S3 表类数据存储服务是专为分析工作负载优化的存储解决方案。它采用 Apache Iceberg 格式,能够高性能、可扩展且安全地存储结构化表格数据,如物联网(IoT)传感器读取数据。
EMQX Cloud 现已支持与 Amazon S3 表类数据存储服务的无缝集成,可高效地将 MQTT 消息存储至 S3 表存储桶中。通过该集成,用户可构建灵活且可扩展的 IoT 数据存储方案,并利用 Amazon Athena、Amazon Redshift 和 Amazon EMR 等 AWS 服务开展高级数据分析与处理。
本页详细介绍了 EMQX Cloud 与 Amazon S3 Tables 的数据集成并提供了实用的规则创建指导。
工作原理
EMQX Cloud 与 Amazon S3 表类数据存储服务集成,支持将实时的 MQTT 数据结构化写入 Amazon S3 表数据存储服务中,实现长期存储与数据分析。此集成通过 EMQX Cloud 的规则引擎和 S3 Tables Sink,将 MQTT 消息直接流式写入采用 Apache Iceberg 格式的表,并存储于 S3 表存储桶中。
在典型的 IoT 应用场景中:
- EMQX Cloud 作为 MQTT 消息代理,负责设备接入、消息路由及数据处理。
- Amazon S3 表类数据存储服务用作 MQTT 消息的结构化存储终端,具备持久性和可查询性。
- Amazon Athena 用于定义 Iceberg 格式的表并对存储的数据执行 SQL 查询。
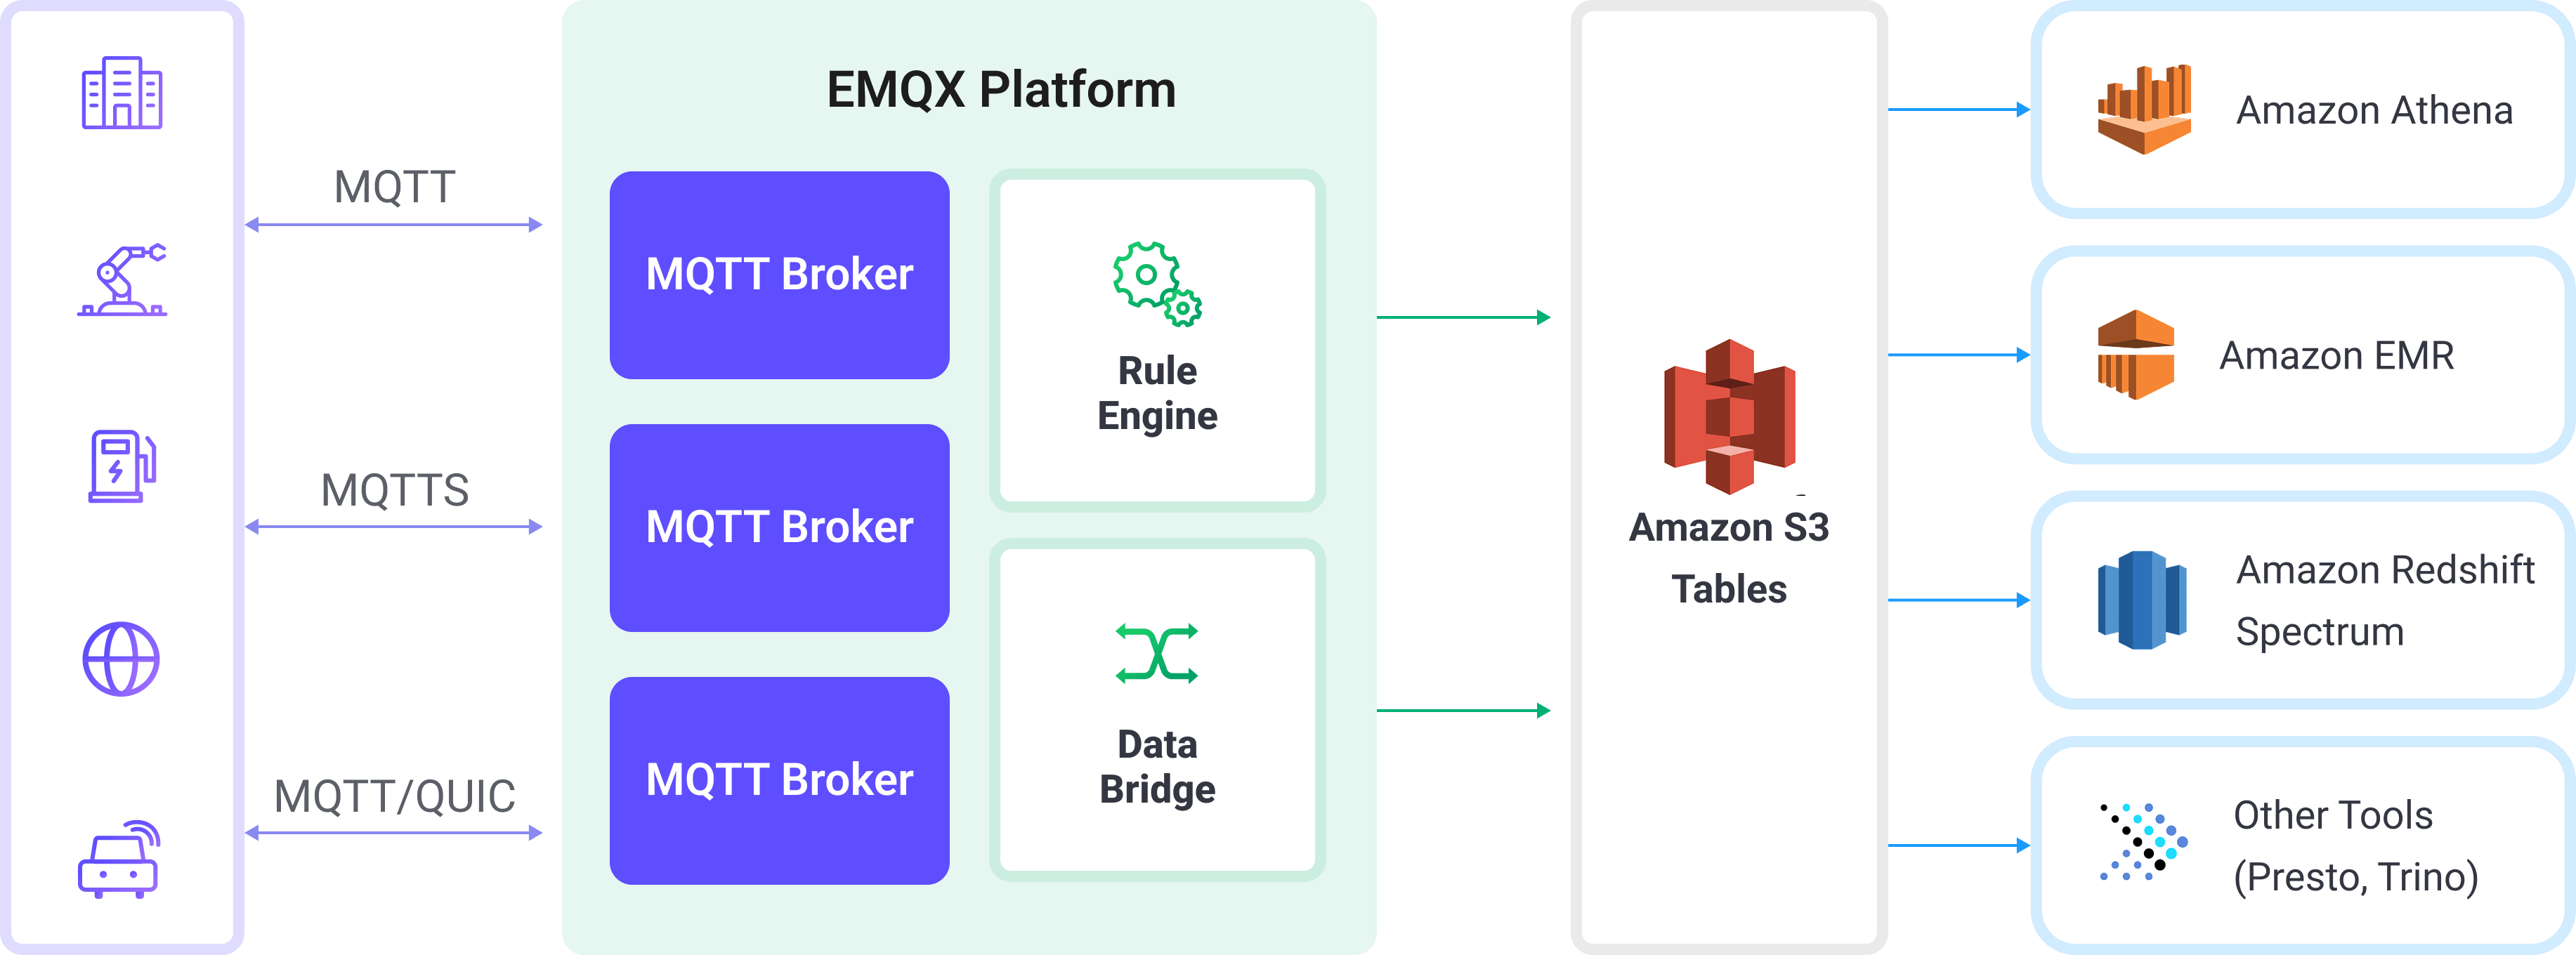
工作流程如下:
- 设备连接至 EMQX Cloud:物联网设备通过 MQTT 协议连接至 EMQX Cloud,并开始发布遥测数据。
- 消息路由与规则匹配:EMQX Cloud 使用其内置的规则引擎将接收到的 MQTT 消息与预定义的主题进行匹配,并提取特定的字段或数值。
- 数据转换:EMQX Cloud 中的规则可以对消息 payload 进行过滤、转换或补充,使其符合目标 Iceberg 表的结构。
- 写入 Amazon S3 表数据存储服务:规则会触发 S3 Tables Sink 动作,将转换后的数据进行批量处理,并通过兼容 Iceberg 的写入 API 发送到 Amazon S3 表中。数据将作为 Parquet 文件持久化存储于 Iceberg 表的分区中。
- 查询与分析:数据写入后,可通过 Amazon Athena 查询,也可以与其他数据集进行联合分析,或通过 Redshift Spectrum、Amazon EMR 以及第三方分析引擎(如 Presto 和 Trino)进行进一步分析处理。
特性与优势
在 EMQX Cloud 中集成 Amazon S3 表数据存储服务,可以为你的业务带来以下功能和优势:
- 实时流处理:EMQX Cloud 的规则引擎支持在消息写入 S3 表数据存储服务之前,实时提取、转换和按条件路由 MQTT 消息。
- 基于 Iceberg 的 S3 存储:消息被写入 Apache Iceberg 表,无需使用传统数据库,同时支持类 SQL 的访问模式。
- 轻松集成分析工具:数据写入 S3 表后,可通过 Amazon Athena(SQL)、Amazon EMR、Redshift Spectrum,或第三方引擎(如 Presto、Trino、Snowflake)进行查询和分析。
- 灵活且具成本效益的存储:Amazon S3 提供高度耐久、低成本的对象存储,适用于设备生成数据的归档、合规存储及时序数据分析等场景。
准备工作
本节介绍了在 EMQX Cloud 中创建 Amazon S3 Tables 数据集成之前需要做的准备工作。
前置准备
在开始之前,请确保你已了解以下内容:
EMQX Cloud 相关概念:
AWS 相关概念:
如果你是第一次使用 AWS S3 表数据存储服务,请了解以下关键术语:
- 表存储桶:一种专用的 S3 存储桶,用于在 S3 表中存储基于 Iceberg 的表格数据及其元数据。
- Amazon Athena:一款无服务器的查询引擎,可直接对存储在 Amazon S3 中的数据执行 SQL 查询。Athena 支持标准 SQL 语法,包括如
CREATE TABLE等数据定义语言(DDL)语句,用于定义查询所需的表结构和模式。 - 目录:Athena 中的元数据容器,用于组织数据库(命名空间)和数据表。
- 数据库(命名空间):目录下用于逻辑分组数据表的结构。
- Iceberg 表:一种用于数据湖的高性能事务型表格式,支持模式演进、分区裁剪和时间旅行查询等特性。
网络设置
由于 EMQX 通过公网访问 Amazon S3,您需要在部署中开通 NAT 网关。您可以在部署左侧菜单栏中点击网络管理,在页面中找到 NAT 网关,点击 +NAT 网关按钮开通 NAT 网关服务。
准备 S3 表存储桶
在创建规则之前,你需要在 Amazon S3 表数据存储服务中准备 MQTT 数据的目标存储,包括以下内容:
- 一个用于存储实际数据文件的表存储桶
- 一个用于逻辑管理相关表的命名空间
- 一个用于接收结构化 MQTT 数据的 Iceberg 表
登录 AWS 管理控制台。
打开 S3 服务。在左侧导航栏中点击表存储桶。
点击创建表存储桶。输入你的表存储桶名称(例如:
mybucket),然后点击创建表存储桶。表存储桶创建完成后,点击该表存储桶,进入其表列表页面。
点击使用 Athena 创建表。此时会弹出一个窗口,提示你选择命名空间。
选择创建命名空间,输入一个命名空间名称,并点击创建命名空间进行确认。
命名空间创建完成后,继续点击使用 Athena 创建表。
定义你的 Iceberg 表结构:
点击使用 Athena 查询表,进入查询编辑器:
- 在目录选择器中,选择你的目录(例如,如果你的表存储桶名为
mybucket,则目录可能为s3tablescatalog/mybucket)。 - 在数据库选择器中,选择刚才创建的命名空间。
- 在目录选择器中,选择你的目录(例如,如果你的表存储桶名为
执行以下数据定义语言(DDL)来创建数据表,并确保表类型设置为
ICEBERG。例如:sqlCREATE TABLE testtable ( c_str string, c_long int ) TBLPROPERTIES ('table_type' = 'ICEBERG');此操作会创建一个 Iceberg 表,用于接收来自 EMQX Cloud 的结构化 MQTT 数据。
验证表是否创建成功。可运行以下 SQL 语句,确认表已创建并当前为空:
SELECT * FROM testtableTIP
在执行查询 SQL 之前,请确保在 Athena 中已选择正确的目录和数据库,以确保数据表被创建在正确的 S3 表存储桶中。
创建连接器
您需要创建对应的 S3 Tables 连接器,以便 EMQX Cloud 与 S3 Tables 服务建立连接:
- 在部署菜单中选择数据集成,在数据持久化分类下选择 S3 Tables。如果您已经创建了其他的连接器,点击新建连接器,然后在数据持久化分类下选择 S3 Tables。
- 输入连接信息:
- 连接器名称:系统将自动生成一个连接器的名称。
- S3 Tables 资源名称(ARN):输入你在 AWS 控制台中 S3 表存储桶列表中找到的 Amazon Resource Name (ARN)。
- 访问密钥 ID 和访问密钥:输入与具有访问 S3 表和 Athena 权限的 IAM 用户或角色关联的 AWS 访问凭证。
- 启用 TLS:连接到 S3 表数据存储服务时是否启用 TLS。有关 TLS 连接选项的详细信息,请参阅外部资源访问的 TLS。
- 其余设置保持默认值。
- 点击创建之前,您可以先点击测试连接来测试连接器是否可以连接到 S3 表数据存储服务。
- 点击最下方创建按钮完成连接器创建。
至此您已经完成连接器创建,接下来将继续创建一条规则和 Sink 来指定需要写入的数据。
创建规则
本节演示了如何在 EMQX Cloud 中创建一条规则,用于处理来自源 MQTT 主题 t/# 的消息,并通过配置的动作将处理后的结果写入到 S3 表数据存储服务的 mybucket 表存储桶中。
点击连接器列表操作列下的新建规则图标或在规则列表中点击新建规则进入新建规则步骤页。
在 SQL 编辑器中输入规则 SQL 如下:
TIP
请确保规则输出的字段名与 Iceberg 表的列名一致。如果缺少必须的列名,数据写入可能会失败。
sqlSELECT payload.str as c_str, payload.int as c_long FROM "t/#"TIP
如果您初次使用 SQL,可以点击 SQL 示例和启用调试来学习和测试规则 SQL 的结果。
点击下一步开始创建动作。
从使用连接器下拉框中选择您之前创建的连接器。
配置动作:
- 命名空间:你的 Iceberg 表所在的命名空间。如果命名空间为多级结构,使用点号分隔(例如
my.name.space)。 - 表:要写入的 Iceberg 表名称。
- 最大记录数:当达到该数量时,当前数据会被聚合成一个文件上传,并重置时间间隔。
- 时间间隔:达到设定时间后,无论记录数是否达到上限,当前批次也将被上传并重置计数器。
- 命名空间:你的 Iceberg 表所在的命名空间。如果命名空间为多级结构,使用点号分隔(例如
备选动作(可选):如果您希望在消息投递失败时提升系统的可靠性,可以为动作配置一个或多个备选动作。当动作无法成功处理消息时,这些备选动作将被触发。更多信息请参见:备选动作。
根据需要配置高级设置选项(可选)。
点击确认按钮完成动作的配置。
在弹出的成功创建规则提示框中点击返回规则列表,从而完成整个数据集成的配置。
测试规则
本节展示如何测试已配置了 S3 Tables Sink 的规则。
使用 MQTTX 向主题
t/1发布一条消息:bashmqttx pub -i emqx_c -t t/1 -m '{ "str": "hello S3 Tables", "int": 123 }'这条消息包含
payload.str和payload.int字段,与之前定义的规则 SQL 和数据表结构相匹配。在规则页面中监控规则指标和 Sink 状态。你应该会看到一条新的入站消息和一条新的出站消息。
打开 Athena 查询编辑器。确保已选择正确的目录(例如:
s3tablescatalog/mybucket)和数据库(命名空间)。执行以下 SQL 查询:
sqlSELECT * FROM testtable你应该会看到类似如下的一行记录:
c_str c_long hello S3 Tables 123