数据采集、处理与转发
本节是面向真实项目的配置手册:接真实设备、配到上规模、长期稳定运行。如需先用模拟器在十五分钟内完成一条链路,见快速入门。
配置流程
| 步骤 | 做什么 | 重点 |
|---|---|---|
| 1 | 添加南向驱动 | 按设备协议选驱动、填连接参数。各协议的参数、数据类型和地址格式见南向驱动 |
| 2 | 组与点位 | 先定分组策略——组是采集、上报和订阅的最小粒度,分组方式决定了报文结构和带宽 |
| 3 | 数据监控与反控 | 确认点位采集正常,也可从这里向设备写入 |
| 4 | 在转发前处理数据(可选) | 用规则引擎过滤、换算、聚合或改字段名。数据量大、采集频率高于业务需要时尤其值得做 |
| 5 | 创建北向应用 | 确定数据的上报目的地,选型见北向应用 |
| 6 | 订阅南向数据 | 把采集组关联到北向应用,数据开始转发 |
重复第 1、2 步,直至所有设备配置完成;重复第 5、6 步,可将同一份数据同时上报至多个目的地。
第 4 步是可选的:数据可以原样上报,也可以先经规则加工,两条路径可同时存在。判断依据见在转发前处理数据;规则引擎的完整能力(数据源、SQL、窗口、动作)见独立的数据处理一栏。
设备数量多、点位数量大,或者要从 KEPServerEX、Litmus Edge 迁移过来,见批量配置与迁移。
整体流程如下图:
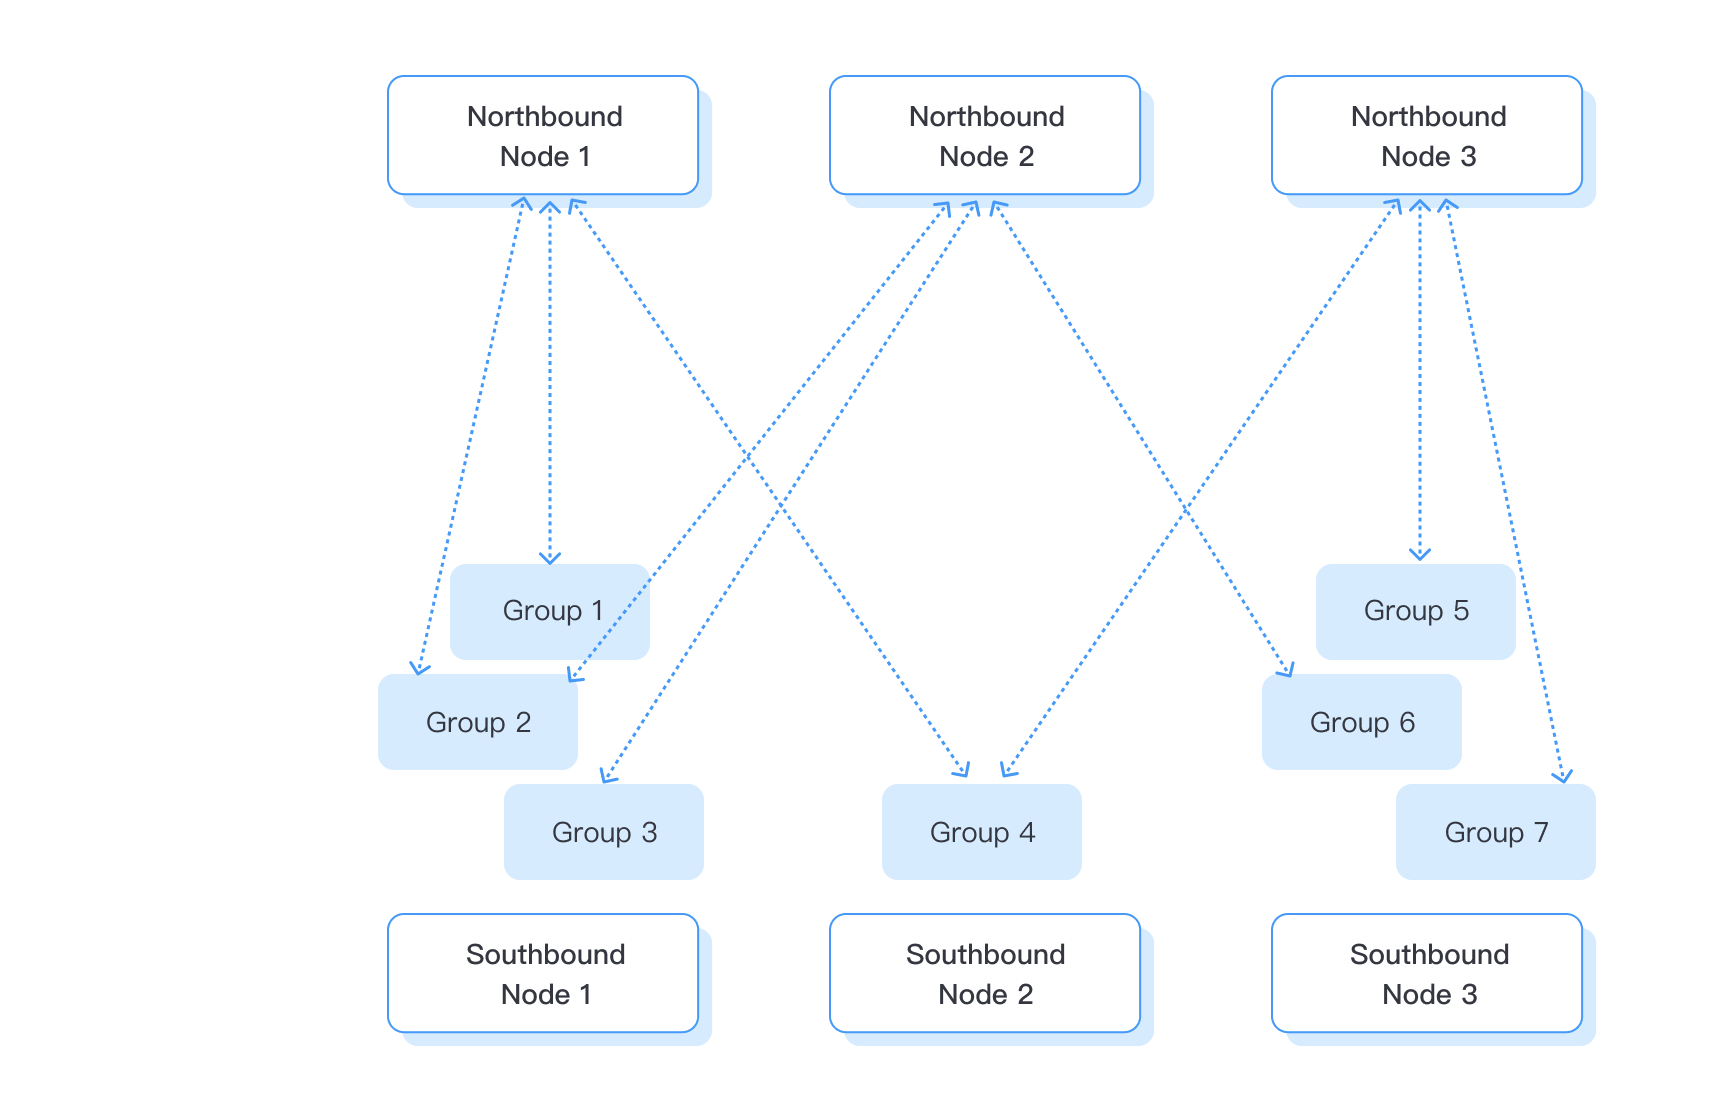
TIP
需要在转发前做过滤、换算或聚合,见数据处理。节点、组、点位三者的关系见架构 · 核心数据模型。
配置规范
项目设计阶段先确认单实例的容量限制:
| 对象 | 规范限制 |
|---|---|
| 节点(Node)名长度 | 最大 128 字符 |
| 点位(Tag)名长度 | 最大 128 字符 |
| 点位(Tag)地址长度 | 最大 128 字符 |
| 点位(Tag)描述信息长度 | 最大 256 字符 |
| 组(Group)名长度 | 最大 128 字符 |
| 单个南向驱动最大 Group 数 | 最大 512 个 |
| 北向应用最大订阅 Group 数 | 无限制 |
| 驱动或应用模块名长度 | 最大 32 字符 |
| 驱动或应用文件名长度 | 最大 64 字符 |
| 驱动或应用描述长度 | 最大 512 字符 |
| 南向驱动采集周期 | 最快 100 毫秒 |
点位总数没有硬性上限,取决于分配的 CPU 和内存,实测数据见性能测试。硬件充足时,单实例建议不超过 10 万个点位、100 个南向驱动;超出这个规模建议拆分为多个 EMQX Neuron 实例,见硬件要求。