Apache KafkaへのMQTTデータストリーミング
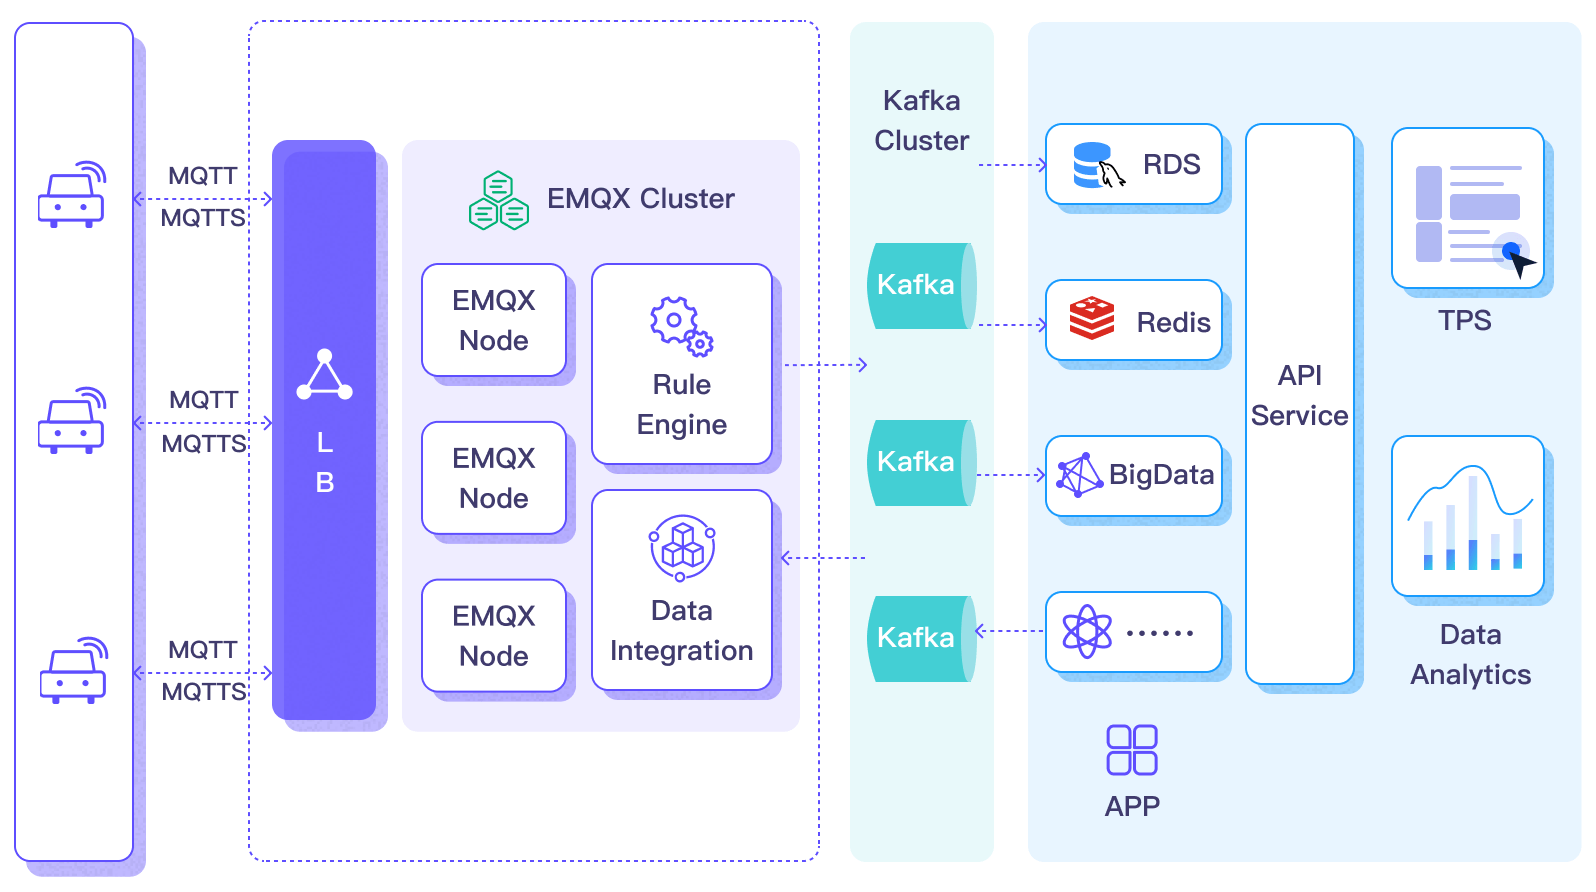
Apache Kafkaは、アプリケーションやシステム間のリアルタイムデータフローを処理できる広く利用されているオープンソースの分散イベントストリーミングプラットフォームです。しかし、KafkaはエッジIoT通信向けに設計されておらず、Kafkaクライアントは安定したネットワーク接続とより多くのハードウェアリソースを必要とします。IoT領域では、デバイスやアプリケーションが生成するデータは軽量なMQTTプロトコルを使って送信されます。EMQX CloudとKafka/Confluentの統合により、ユーザーはMQTTデータをシームレスにKafkaへストリーミングできます。MQTTのデータストリームはKafkaのトピックに導入され、リアルタイムの処理、保存、分析が可能です。現在、EMQX CloudはKafkaへのデータ転送のみをサポートしています。
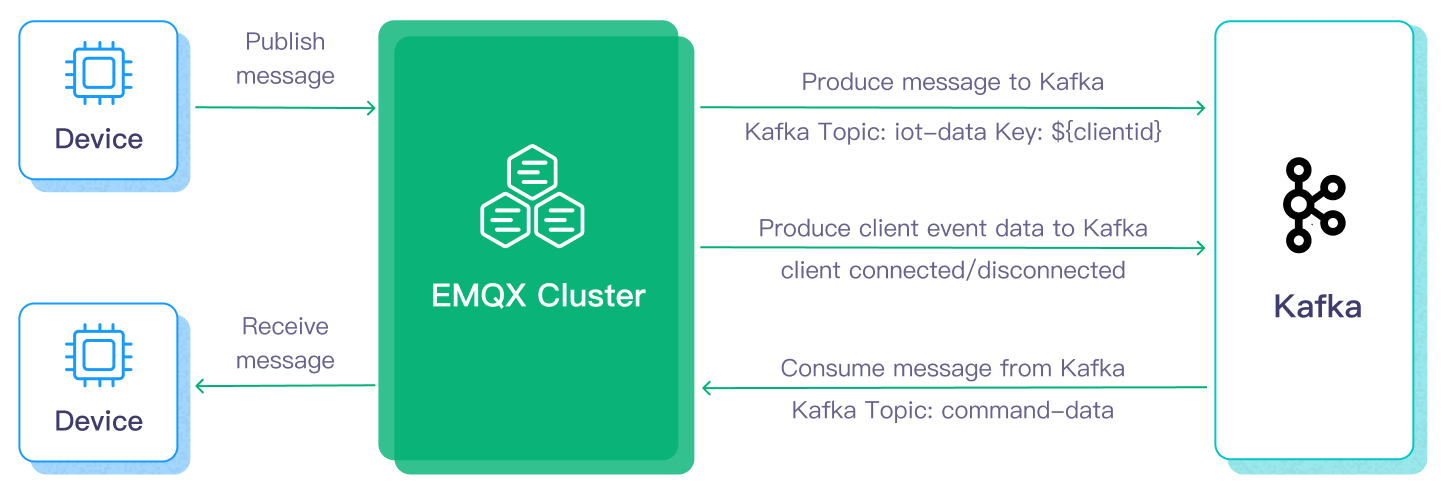
本ページでは、Kafkaデータ統合の機能的特徴を詳細に紹介し、データ統合の作成に関する実践的なガイドを提供します。
動作概要
Apache Kafkaデータ統合はEMQX Cloudの標準機能であり、MQTTベースのIoTデータとKafkaの強力なデータ処理機能を橋渡しします。組み込みのルールエンジンコンポーネントを通じて、複雑なコーディングなしに両プラットフォーム間のデータフローと処理を簡素化します。
Kafkaへのメッセージデータ転送の基本的なワークフローは以下の通りです:
- メッセージのパブリッシュ:デバイスはMQTTプロトコルを介してEMQX Cloudのデプロイメントに正常に接続し、定期的に状態データを含むメッセージをパブリッシュします。EMQX Cloudがこれらのメッセージを受信すると、ルールエンジン内でマッチング処理を開始します。
- メッセージデータの処理:これらのMQTTメッセージは、組み込みのルールエンジンを通じてトピックマッチングルールに基づいて処理されます。メッセージが到着しルールエンジンを通過すると、エンジンはそのメッセージに対して事前定義された処理ルールを評価します。ペイロード変換が指定されている場合は、データ形式の変換、特定情報のフィルタリング、追加コンテキストによるペイロードの強化などの変換が適用されます。
- Kafkaへの送信:ルールエンジンで定義されたルールは、メッセージをKafkaに転送するアクションをトリガーします。Kafkaデータ統合を使用して、MQTTトピックは事前定義されたKafkaトピックにマッピングされ、すべての処理済みメッセージとデータがKafkaトピックに書き込まれます。
Kafkaからのメッセージ消費の基本的なワークフローは以下の通りです:
- Kafkaトピックのサブスクライブ:ルールエンジンの入力ソースでKafkaコンシューマのアクションを定義し、消費するKafkaトピック名を設定します。EMQXデプロイメントがこれらのメッセージを受信すると、ルールエンジン内でマッチング処理を開始します。
- メッセージデータの処理:組み込みのルールエンジンを通じて、メッセージが到着しルールエンジンを通過すると、エンジンはそのメッセージに対して事前定義された処理ルールを評価します。ペイロード変換が指定されている場合は、データ形式の変換、特定情報のフィルタリング、追加コンテキストによるペイロードの強化などの変換が適用されます。
- MQTTクライアントへの転送:ルールエンジンで定義されたルールは、メッセージをMQTTトピックに転送するアクションをトリガーします。Kafkaデータ統合を使用して、Kafkaトピックは事前定義されたMQTTトピックにマッピングされ、すべての処理済みメッセージとデータがMQTTクライアントによって消費可能になります。
特徴と利点
Apache Kafkaとのデータ統合は、以下の特徴と利点をビジネスにもたらします:
- ペイロード変換:送信中にメッセージペイロードは定義されたSQLルールを通じて処理可能です。例えば、総メッセージ数、成功/失敗配信数、メッセージレートなどのリアルタイムメトリクスを含むペイロードは、Kafkaに入力する前にデータ抽出、フィルタリング、強化、変換を受けられます。
- 効果的なトピックマッピング:設定されたKafkaデータ統合を通じて、多数のIoTビジネストピックをKafkaトピックにマッピング可能です。EMQXはMQTTユーザープロパティをKafkaヘッダーにマッピングすることをサポートし、1対1、1対多、多対多の柔軟なトピックマッピング方法やMQTTトピックフィルター(ワイルドカード)もサポートしています。
- 柔軟なパーティション選択戦略:MQTTトピックまたはクライアントに基づき、同じKafkaパーティションへのメッセージ転送をサポートします。
- 高スループット下での処理能力:EMQX Kafkaプロデューサーは同期および非同期書き込みモードをサポートし、リアルタイム優先とパフォーマンス優先のデータ書き込み戦略を柔軟に選択可能です。
- ランタイムメトリクス:各データブリッジの総メッセージ数、成功/失敗数、現在のレートなどのランタイムメトリクスの閲覧をサポートします。
これらの特徴は統合能力と柔軟性を高め、効果的かつ堅牢なIoTプラットフォームアーキテクチャの構築を支援します。増大するIoTデータは安定したネットワーク接続のもとで送信され、さらに効果的に保存・管理されます。
はじめる前に
このセクションでは、EMQX CloudでKafkaデータ統合を作成するための準備作業を紹介します。
前提条件
ネットワーク設定
データ統合を構成する前に、EMQX Cloudのデプロイメントを作成し、EMQX Cloudと対象サービス間のネットワーク接続を確立していることを確認してください。
Dedicated Flexデプロイメントの場合:
EMQX CloudのVPCと対象サービスのVPC間でVPCピアリング接続を作成します。ピアリング接続が確立されると、EMQX Cloudは対象サービスのプライベートIPアドレスを介してアクセス可能になります。
パブリックIP経由でのアクセスが必要な場合は、NATゲートウェイを構成してアウトバウンド接続を有効にしてください。
BYOC(Bring Your Own Cloud)デプロイメントの場合:
BYOCデプロイメントが稼働しているVPCと対象サービスをホストするVPC間でVPCピアリング接続を作成します。ピアリングが確立されると、対象サービスのプライベートIPアドレスを介してアクセス可能になります。
対象サービスにパブリックIP経由でアクセスする必要がある場合は、クラウドプロバイダーのコンソールを使用してBYOC VPCにNATゲートウェイを構成してください。
Kafkaのインストールとトピック作成
Kafkaをインストールします。
bash# Zookeeperのインストール docker run -d --restart=always \ --name zookeeper \ -p 2181:2181 \ zookeeper # Kafkaのインストール(ポート9092を開放) docker run -d --restart=always --name mykafka \ -p 9092:9092 \ -e HOST_IP=localhost \ -e KAFKA_ADVERTISED_PORT=9092 \ -e KAFKA_ADVERTISED_HOST_NAME=<Server IP> \ -e KAFKA_BROKER_ID=1 \ -e KAFKA_LOG_RETENTION_HOURS=12 \ -e KAFKA_LOG_FLUSH_INTERVAL_MESSAGES=100000 \ -e KAFKA_ZOOKEEPER_CONNECT=<Server IP>:2181 \ -e ZK=<Server IP> \ wurstmeister/kafkaトピックを作成します。
bash# Kafkaインスタンスに入り、emqxトピックを作成 $ docker exec -it mykafka /opt/kafka/bin/kafka-topics.sh --zookeeper <broker IP>:2181 --replication-factor 1 --partitions 1 --topic emqx --create
"Created topic emqx." と表示されれば作成成功です。
メッセージデータをKafkaへストリーミング
このセクションでは、MQTTプロトコルを介してシミュレートした温度・湿度データをEMQXデプロイメントに報告し、設定したデータ統合を通じてKafkaに転送する方法を示します。内容はKafkaプロデューサーコネクターの作成、ルールの作成、ルールのテストを含みます。
Kafkaプロデューサーコネクターの作成
データ統合ルールを作成する前に、KafkaサーバーにアクセスするためのKafkaプロデューサーコネクターを作成する必要があります。
- デプロイメントに移動し、左ナビゲーションメニューからデータ統合をクリックします。
- 初めてコネクターを作成する場合は、データ転送カテゴリの中からKafka Producerを選択します。すでにコネクターを作成済みの場合は、新規コネクターを選択し、続いてデータ転送カテゴリのKafka Producerを選択します。
- 新規コネクターページで以下のオプションを設定します:
- コネクター名:システムが自動的に名前を生成しますが、任意の名前を付けることも可能です。本例では
my_kafkaserverを使用できます。 - Bootstrap Hosts:ホストリストを入力し、Kafkaサービスにネットワーク経由で正常にアクセスできることを確認します。EMQX 6.1.5以降のデプロイメントでは、IPv6アドレスは角括弧で囲みます(例:
[2001:db8::1]:9092)。 - IPファミリー:EMQX 6.1.5以降のデプロイメントでは、Kafkaブローカーへの接続に使用するIPアドレスファミリーを選択します:
- Auto (
auto):デフォルト。IPアドレスの場合はそのアドレスファミリーを使用。ホスト名の場合はIPv4を優先し、失敗時にIPv6を試行します。 - IPv4 (
ipv4):IPv4のみで接続。 - IPv6 (
ipv6):IPv6のみで接続。
- Auto (
- その他の設定はデフォルト値を使用するか、ビジネスニーズに応じて設定します。
- コネクター名:システムが自動的に名前を生成しますが、任意の名前を付けることも可能です。本例では
- テストボタンをクリックします。Kafkaサービスにアクセス可能であれば成功のプロンプトが返されます。
- 新規作成ボタンをクリックして作成を完了します。
ルールの作成
次に、書き込むデータを指定し、処理済みデータをKafkaに転送するためのアクションをルールに追加します。
ルールエリアの新規ルールをクリックするか、作成したコネクターのアクション列にある新規ルールアイコンをクリックします。
SQLエディターにルールマッチングSQL文を入力します。以下のSQL例は、
temp_hum/emqxトピックに送信されたメッセージから報告時刻up_timestamp、クライアントID、メッセージ本文(ペイロード)を読み取り、温度と湿度を抽出します。sqlSELECT timestamp, clientid, payload.temp as temp, payload.hum as hum FROM "temp_hum/emqx"Try It Outを使ってデータ入力をシミュレートし、結果をテストできます。
次へをクリックしてアクションを追加します。
コネクターのドロップダウンから先ほど作成したコネクターを選択します。
以下の情報を設定します:
アクション名:システムが自動生成しますが、任意の名前を付けることも可能です。
Kafkaトピック名:先に作成したトピック
emqxを入力します。Kafkaヘッダー:ビジネスニーズに応じてKafkaヘッダーを定義します。
メッセージ本文設定では、メッセージキーはルールから取得したクライアントIDがデフォルトですが、必要に応じて変更可能です。メッセージ値には転送する温度と湿度の値を入力します。
bash# Kafkaメッセージ値 {"temp": ${temp}, "hum": ${hum}}その他の設定はデフォルト値を使用するか、ビジネスニーズに応じて設定します。
確認ボタンをクリックしてルール作成を完了します。
新規ルール作成成功のポップアップでルールに戻るをクリックし、データ統合の設定チェーン全体を完了します。
作成成功後、新規ルールページに戻ります。ルールリストに新規作成したルールが表示され、アクションリストの**アクション(シンク)**にデータインポートアクションの一覧が表示されます。
ルールのテスト
MQTTXを使って温度・湿度データの報告をシミュレートすることを推奨しますが、他のクライアントでも可能です。
MQTTXでデプロイメントに接続し、以下のトピックにメッセージを送信します。
トピック:
temp_hum/emqxペイロード:
json{ "temp": "27.5", "hum": "41.8" }
メッセージがKafkaに転送されているか確認します。
bash# Kafkaインスタンスに入り、emqxトピックを確認 $ docker exec -it mykafka /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server <broker IP>:9092 --topic emqx --from-beginningコンソールで運用データを確認します。ルールリストのルールIDをクリックすると、そのルールの統計情報とルール配下のすべてのアクションの統計が表示されます。
Kafkaからのメッセージ消費
このセクションでは、EMQXデプロイメントがKafkaからメッセージを消費し、設定したデータ統合を通じてMQTTトピックにメッセージデータを再パブリッシュする方法を示します。内容はKafkaコンシューマーコネクターの作成、ルールの作成、ルールのテストを含みます。
Kafkaコンシューマーコネクターの作成
Kafkaコンシューマーを追加する前に、EMQXデプロイメントとKafka間の接続を確立するためのKafka Consumer Connectorを作成する必要があります。
- デプロイメントメニューでデータ統合を選択し、データインポートサービスカテゴリの中からKafka Consumerを選択します。すでに他のコネクターを作成済みの場合は、新規コネクター作成をクリックし、続いてデータインポートのKafka Consumerを選択します。
- コネクター作成ページで以下を設定します:
- コネクター名:システムが自動的に
connector-で始まる名前を生成します。 - ホストリスト:Kafkaサービスにネットワーク経由で正常にアクセスできるようホストリストを入力します。EMQX 6.1.5以降のデプロイメントではIPv6アドレスを角括弧で囲みます(例:
[2001:db8::1]:9092)。 - IPファミリー:Kafkaブローカーへの接続に使用するIPアドレスファミリーを選択します:
- Auto (
auto):デフォルト。IPアドレスの場合はそのアドレスファミリーを使用。ホスト名の場合はIPv4を優先し、失敗時にIPv6を試行します。 - IPv4 (
ipv4):IPv4のみで接続。 - IPv6 (
ipv6):IPv6のみで接続。
- Auto (
- 認証:必要に応じて認証方式を入力します。ここではベーシック認証を使用します。
- 認証方式:Kafkaサービスの認証要件に応じて
plain、SHA256、SHA512から選択。 - ユーザー名:Kafkaサービスのユーザー名(通常はAPIキー)。
- パスワード:Kafkaサービスの認証パスワード(通常はAPIシークレット)。
- 認証方式:Kafkaサービスの認証要件に応じて
- その他の設定はデフォルト値を使用するか、ビジネスニーズに応じて設定します。
- コネクター名:システムが自動的に
- 接続テストボタンをクリックし、Kafkaサービスに正常にアクセスできれば成功メッセージが返されます。
- 作成ボタンをクリックして設定を完了します。
ルールの作成
次に、入力データとルールエンジンの処理ルールを指定し、ルールで処理したデータを対応するトピックに転送する出力アクションを追加します。
コネクターリストのアクション列にある新規ルールアイコンをクリックするか、ルールリスト上部の新規ルールをクリックして新規ルール作成ページに入ります。
コンシューマールールでは、まず入力アクションを設定する必要があります。ルール編集ページで自動的に入力アクション設定がポップアップするか、アクション(ソース) -> 新規アクション(ソース)を選択し、パネルでKafka Consumerを選択して次へをクリックします。
- Kafka Consumer Connectorを選択します。
- Kafkaトピック:Kafkaから消費するトピック名を入力します(例:
temp_hum/emqx)。 - グループID:このソースのコンシューマーグループ識別子を指定します。空欄の場合はソース名に基づいて自動生成されます。文字、数字、アンダースコア、ドット、ハイフンのみ使用可能です。
- キーエンコードモードおよび値エンコードモード:Kafkaメッセージのキーと値のエンコードモードを選択します。
- オフセットリセットポリシー:コンシューマーがKafkaトピックパーティションの読み取りを開始する際のオフセットリセット戦略を選択します。コンシューマーオフセットが存在しないか無効な場合に適用されます。
- 最新のオフセットから読みたい場合は
latestを選択し、コンシューマー開始前のメッセージはスキップされます。 - パーティションの先頭から読みたい場合は
earliestを選択し、開始前のメッセージも含めてすべての履歴データを読み取ります。
- 最新のオフセットから読みたい場合は
確認ボタンをクリックして設定を完了します。
SQLエディターはデータソースフィールドを更新し、
SELECTで転送するフィールドを選択可能になります。sqlSELECT key as key, value as value, topic as topic FROM "$bridges/kafka_consumer:source-812985f2"次へをクリックし、出力アクションを作成します。
新規出力アクションで再パブリッシュを選択します。
出力アクション情報を設定します:
- トピック:転送先のMQTTトピックを指定します。
${var}形式のプレースホルダーをサポートします。ここではsub/${topic}を入力し、元のトピックにsub/プレフィックスを付加して転送します。例えば、元トピックがt/1の場合、転送先はsub/t/1となります。 - QoS:メッセージパブリッシュのQoSを
0、1、2または${qos}から選択、または他フィールドからQoSを設定するためのプレースホルダーを入力可能です。ここでは元メッセージのQoSを引き継ぐため${qos}を選択します。 - リテイン:
true、false、または${flags.retain}を選択し、メッセージをリテインメッセージとしてパブリッシュするかを指定します。プレースホルダーを使って他フィールドからリテインフラグを設定することも可能です。ここでは元メッセージのリテインフラグを引き継ぐ${flags.retain}を選択します。 - メッセージテンプレート:転送するメッセージペイロードの生成テンプレートです。デフォルトは空欄でルール出力結果をそのまま転送します。ここでは
${.}を入力し、ルールエンジン内のすべてのフィールドを転送します。
- トピック:転送先のMQTTトピックを指定します。
その他の設定はデフォルト値を使用し、確認ボタンをクリックして出力アクション作成を完了します。
作成成功後、新規ルールページに戻ります。ルールリストに新規作成したルールが表示されます。再パブリッシュアクションは現在**アクション(ソース)**には表示されません。必要に応じてルール編集ボタンをクリックすると、ルール設定の下部に再パブリッシュ出力アクションが表示されます。
ルールのテスト
Kafkaトピックtemp_hum/emqxにメッセージを送信し、デプロイメント内の転送先トピックをサブスクライブしてルールをテストできます。temp_hum/emqxトピックにメッセージがパブリッシュされると、デプロイメント内のsub/temp_hum/emqxトピックに転送されます。
以下はMQTTXを使って転送されたMQTTトピックをサブスクライブし、メッセージを受信する手順例です。
MQTTXで現在のデプロイメントのトピック
sub/#をサブスクライブします。Kafkaプロデューサーや他のツールを使って
temp_hum/emqxトピックにメッセージをパブリッシュします:json{ "temp": 55, "hum": 32 }MQTTXはデプロイメント内の
sub/temp_hum/emqxトピックでメッセージを受信します:json{ "key": "", "value": { "temp": 55, "hum": 32 } }